Tensores para Machine Learning — de datos reales a modelos modernos. Ravi Kalia y Sebastian Laverde Chunza.
Dilo en voz alta: nadie tiene por qué saber teoría de tensores. Cada término nuevo se define la primera vez que aparece. Habla despacio y evita modismos; nombra pronto los cognados: eje, descomposición, contracción, convolución.
Predicción: los mismos números — ¿sigue sonando a voz?
Reproduce la voz tal como se construyó y luego cambia la disposición y reprodúcela otra vez: los mismos 263.169 números, solo en otro orden.
Abrir el widget de voz ↗
Sonido activado — prueba los altavoces de la sala antes de que llegue el grupo; esto solo funciona si lo oyen. Reproduce la voz tal como la construyó la transformada: suena a voz. Cambia Disposición a transpuesta y reproduce de nuevo: los mismos 263.169 números, solo reordenados, y es ruido.
El número que hay que señalar: 263.169 — dilo en voz alta las dos veces, para que la sala oiga que no se perdió nada.
Pregunta por qué una transposición que no pierde nada arruina igual el sonido — y no respondas. Promete que la sección 04 y la última diapositiva del cierre vuelven sobre esto.
La idea del workshop: cuatro tarjetas muestran escalar, vector, matriz y tensor como arreglos 0D, 1D, 2D y ND, cada uno definido por su forma. La pregunta guía del día: antes de operar, ¿qué representa cada eje?
Cuatro ideas, un solo objeto. Todo el día en cuatro tarjetas. Tarjeta uno: un tensor generaliza la matriz. Un escalar no tiene ejes, un vector uno, una matriz dos, y un tensor tantos como pidan los datos. Tarjeta dos: contiene los datos. Imágenes, fotogramas, viajes en taxi y precios son una sola caja de números, y cada eje representa algo. Tarjeta tres: sus ejes se mueven. transpose los permuta. reshape relee los mismos números planos, así que la misma forma puede tener otro significado. Tarjeta cuatro: se factoriza. Los números en primos, las cuadráticas en raíces, las matrices en LU, QR y SVD, y los tensores también. Y donde no hay inversa, responde la pseudoinversa. Llévate esto todo el día: antes de operar sobre un tensor, nombra sus ejes.
Este es el mapa del día, y la única diapositiva que muestra las cuatro ideas juntas. Dedícale un minuto, no cinco. Cada tarjeta se abre después: la 1 en la sección 01, la 2 en las secciones 02 y 03, la 3 en la sección 04, y la 4 en las secciones 07, 09, 10 y 11.
La cuarta tarjeta es la que hay que vender. El grupo ya factoriza números y resuelve cuadráticas. La afirmación es que factorizar es el mismo movimiento cada vez, aplicado a un objeto más grande. Esa es la promesa que cobra la sección 09.
Di “ejes”, no “dimensiones”, de aquí en adelante — y recuerda que la advertencia sobre “rango” toca al empezar la Parte I.
Datos reales, problemas reales. Cuatro conjuntos de datos reales usados en el taller: dígitos manuscritos, histología teñida, vivienda en California y viajes en taxi de NYC. Cada uno lleva el papel que cumple más adelante.
Lo importante de la cuadrícula es que cada tarjeta es un enlace: quien quiera puede ir a ver la fuente, y varios lo harán. Menciona los dos casos que sorprenden: los dígitos son el conjunto UCI de 8x8, no MNIST, y la célula es una imagen de fase de un holograma, no una preparación teñida — la tarjeta de histología que tiene al lado sí lo es.
Créditos de las imágenes, ninguno obligatorio: taxis Ferdinand Stohr, DC-3 Bernard Spragg, histopatología Mikael Haggstrom MD, viviendas en serie Alfred Twu (Wikimedia Commons); tormenta Nicolas Vigier (Commons); voz Bart Massey — todas CC0. Los dígitos, la célula, la histología y la onda se generan a partir de los propios datos con scripts/gen_thumbnails.py; también son CC0, salvo la histología, que skimage documenta sin restricciones de copyright conocidas.
Programa — 210 minutos
00:00
5
—
Preparación y bienvenida
00:05
20
I
Qué es un tensor
00:25
20
II
Pensar en N dimensiones
00:45
30
III
Indexación y broadcasting · Reshape y transposición
01:15
10
🎯
Kahoot 1 + pausa
01:25
15
III
Diseño de un pipeline de vídeo (grupo)
01:40
15
IV
Contracción con einsum
01:55
5
—
Pausa
02:00
15
IV
Inversas y la pseudoinversa
02:15
5
🎯
Kahoot 2
02:20
25
IV
Recursión · Factorizaciones matriciales
02:45
5
—
Pausa
02:50
15
IV
Descomposición de Tucker
03:05
5
🎯
Kahoot 3
03:10
15
IV
Factorizaciones tensoriales
03:25
5
—
Cierre y ejercicios para casa
Da la advertencia sobre «rango» al principio de la parte I, no después. Es la fuente de confusión más fiable de este taller. El capítulo 2 usa rango para el número de columnas independientes, y la teoría de tensores suele referirse al número de ejes. Hoy: «orden» para el número de ejes, y «rango» solo en el sentido del capítulo 2.
El ritmo, para que la sala sepa qué esperar: una sección empieza con una predicción, sigue con un ejercicio con su propia comprobación, y la mayoría termina con una actividad grupal de 6 a 8 minutos cuya puesta en común de tres líneas va a Discord. El guion de la guía de facilitación tiene el reparto de cada sección. Cada sección recorre solo la ruta esencial de su cuaderno; Explora después queda para después.
00 · Preparación y bienvenida
Practica hoy
Nombrar ejes posibles y predecir un corte en el diagnóstico inicial.
Explora después
Después del diagnóstico, repasar ejemplos de calidad de datos. Completar la preparación antes de clase.
Colab ↗
01 · Qué es un tensor
Practica hoy
Nombrar los ejes de imágenes y distinguir forma, orden y número de elementos.
Explora después
Extraer cortes y fibras, y desplegar imágenes como matrices.
Colab ↗
📖 De NumPy a JAX ↗
Abre con la foto: ¿cuántos números la guardan? 512 × 512 × 3 = 786 432. La franja son 4 minutos modelando una forma y 16 para el Ejercicio 1 con revisión en pareja; las tres diapositivas de computación tras las dos imágenes se hojean, no se enseñan. Atento a «rango» usado para el número de ejes: di «orden».
Mapa de las factorizaciones: seis factorizaciones de matrices y tensores en una escalera desde LU hasta Cholesky, QR, SVD, Tucker y CP, cada una con una frase que resume qué aporta.
La sección 09 recorre este mapa sobre datos reales: cada factorización escrita como un problema de optimización con restricciones, el coste de cada una deducido y luego medido, y la SVD como la mejor aproximación de rango k que existe. La pregunta “cuál elijo y cuánto me cuesta” que plantea esta escalera se responde dos horas después, en la sala.
📖 ¿Por qué hay tantas factorizaciones matriciales? ↗
La factorización en primos es única salvo el orden — el caso más limpio de la diapositiva. Los factores genéricos de una matriz de bajo rango tienen libertad de gauge (el par \(M\) /\(M^{-\top}\) ); una estructura adicional o una convención — pivotes positivos, columnas ortonormales, diagonal positiva — es lo que restaura la unicidad en LU, QR o Cholesky. CP puede ser esencialmente único bajo condiciones de identificabilidad adecuadas, salvo permutación y una escala compensatoria no nula entre modos; sobre los reales, los cambios de signo son un caso particular de esa escala. La condición de Kruskal \(k_A + k_B + k_C \ge 2R + 2\) es suficiente , no necesaria, y no dice nada sobre si la descomposición es fácil de encontrar. Vale la pena mencionar si hay tiempo: calcular el rango tensorial es NP-difícil en general, el rango tensorial puede superar cada dimensión individual de los ejes, y una mejor aproximación de rango \(R\) puede no existir siquiera — nada de eso es cierto para matrices.
Señala aquí hacia la sección 09. Este es el minuto en que alguien se pregunta por qué hay tantas, y 09 es donde se recorre el mapa con una columna de coste al lado.
¿Qué aporta una factorización? Un diagrama de cuatro pasos — número, polinomio, matriz, tensor — muestra que factorizar revela estructura útil y no solo reescribe una expresión.
NumPy: un búfer, distintas vistas
Un ndarray combina valores en memoria con metadatos que indican cómo leerlos.
import numpy as np= np.arange(24 , dtype= np.float32).reshape(2 , 3 , 4 )= T.transpose(2 , 0 , 1 )# True
Arreglo
Forma
Strides · bytes
T
(2, 3, 4)
(48, 16, 4)
T_t
(4, 2, 3)
(4, 48, 16)
Mismos datos. Ejes reordenados.
96 bytes
24 valores × 4 bytes por float32
Strides
Pasos en bytes por eje. Transponer reordena esos pasos.
Vectorización
Bucles numéricos compilados reducen el trabajo del intérprete.
Broadcasting
Formas alineadas por la derecha: tamaños iguales o uno es 1. Sin replicar entradas.
Travis Oliphant · 2005
Numeric 1995 → Numarray 2001 2005 → NumPy 1.0 2006
Explora NumPy ↗
No entra en la franja en directo: los minutos de la sección 01 son del cuaderno. Hojéala en veinte segundos u omítela; está para leerla después.
Travis Oliphant escribió Guide to NumPy y luego cofundó Continuum Analytics, hoy Anaconda. El slicing básico y la transposición producen vistas; la indexación avanzada produce copias. Los 96 bytes cuentan solo el búfer de datos, sin los metadatos.
Conecta los conceptos de tensor con los arreglos de la sección 02. Lee los strides como pasos en bytes: avanzar una posición en el primer eje de T salta 48 bytes. Pregunta qué eje original pasa a ser el primero de T_t (el eje 2). Broadcasting evita replicar las entradas, pero la operación puede crear una salida grande. Reshape puede necesitar una copia si los strides actuales no permiten expresar la nueva forma. Vectorizar con NumPy no traslada el cálculo automáticamente a una GPU.
Fuentes: Organización interna de NumPy , copias y vistas , broadcasting , historia de NumPy , Guide to NumPy , orígenes de Anaconda .
Hardware para operaciones tensoriales
La carga de trabajo determina qué arquitectura ayuda.
D = AB + C
Arquitectura
Cómo calcula
Uso más adecuado
Ejemplos de memoria
CPU Propósito general
Varios núcleos + SIMDControl de flujo flexible
Tareas generales
Cachés + DRAM DDR
GPU NVIDIA
SIMT + Tensor CoresPlataforma CUDA
Contracciones paralelas
GDDR o HBM
TPU Google · ASIC especializado
Unidades matriciales sistólicasOperandos entre vecinos (MXU)
Productos matriciales densos
Búferes internos + HBM
Otros ASIC de ML
Flujo de datos especializado
Cargas específicas
SRAM, DRAM o HBM
La memoria y la precisión admitida varían según la generación del dispositivo.
Mover datos cuesta tiempo. Reutiliza datos en el dispositivo. Operaciones pequeñas y transferencias repetidas pueden anular la mejora.
No entra en la franja en directo: los minutos de la sección 01 son del cuaderno. Hojéala en veinte segundos u omítela; está para leerla después.
El ancho de banda limita muchas operaciones elemento a elemento; los productos matriciales grandes con buen uso de bloques pueden quedar limitados por el cómputo. Ejemplo de Volta: un Tensor Core realiza un producto 4×4 con acumulación por ciclo, con entradas FP16 y acumulación FP32. Otras generaciones difieren.
SIMD significa una instrucción, múltiples datos. SIMT significa una instrucción, múltiples hilos. Una malla sistólica pasa operandos entre elementos vecinos en vez de consultar la memoria en cada paso. Aun así necesita búferes y transferencias. HBM significa memoria de alto ancho de banda.
La operación 4 por 4 por ciclo describe el rendimiento de un Tensor Core de Volta, no la latencia de un producto matricial arbitrario ni una regla para todas las generaciones. La tabla presenta familias de memoria, sin suponer que toda CPU usa DDR5 o toda GPU usa HBM3e. Una TPU también es un circuito integrado de aplicación específica (ASIC).
Fuentes: Guía de rendimiento de GPU NVIDIA , Tensor Cores de Volta , arquitectura de TPU de Google .
Bibliotecas numéricas y frameworks de ML
Las operaciones tensoriales se apoyan en rutinas numéricas optimizadas.
Dentro de una operación de NumPy
A @ BProducto matricial BLAS
np.linalg.svd(A)Descomposición en valores singulares LAPACK
BLAS · operaciones estándar en tres niveles
1 · Vector
2 · Matriz–vector
3 · Matriz–matriz
Producto punto
y = Ax
C = AB
LAPACK usa BLAS para sistemas lineales, SVD y problemas de autovalores.
Bibliotecas de aceleración
Los frameworks añaden más
Diferenciación automática · selección de dispositivo · compilación
PyTorch
Autograd dinámicotorch.compile
JAX
Transformaciones componiblesjit · vmap · grad
TensorFlow
Ejecución inmediata + grafostf.function
Keras 3
API de modelos sobre
Haiku / Flax
Módulos de redes neuronales en JAX
Nombra los ejes. Comprueba las formas. Estos hábitos sirven en todos los frameworks.
No entra en la franja en directo: los minutos de la sección 01 son del cuaderno. Hojéala en veinte segundos u omítela; está para leerla después.
LAPACK sucedió a LINPACK y EISPACK. Las bibliotecas de descomposición tensorial reutilizan rutinas matriciales. Las funciones puras de JAX permiten el trazado y la compilación con XLA. TensorFlow incluye herramientas para servir modelos. Haiku y Flax gestionan parámetros de redes neuronales. Las operaciones de NumPy pueden usar bibliotecas optimizadas; no garantizan un backend concreto.
BLAS es una interfaz con varias implementaciones, como OpenBLAS y MKL. LAPACK ofrece algoritmos matriciales, no algoritmos generales de factorización tensorial. La selección de rutinas depende de la operación, el dtype, la disposición de memoria y el backend instalado. Un framework puede usar bibliotecas del fabricante o generar sus propios kernels. oneDNN ofrece primitivas de redes neuronales y no sustituye directamente a BLAS.
Conecta con la siguiente sección: antes de elegir un backend, nombra los ejes y comprueba las formas. Esos hábitos sirven en todos los frameworks.
Fuentes: BLAS , introducción a LAPACK , cuBLAS , cuTENSOR , oneDNN , autograd de PyTorch , conceptos de JAX , grafos de TensorFlow , Keras 3 , Haiku , Flax .
02 · Pensar en N dimensiones
Practica hoy
Mantener imágenes y etiquetas emparejadas al barajar; explicar por qué barajar el tiempo cambia una secuencia.
Explora después
Construir lotes de video con relleno e interpretar otros ejes experimentales.
Colab ↗
Abre con la predicción: si barajas cuatro fotogramas, ¿qué estadística cambia? (2 min). Después la clave de ejes y el Ejercicio 2 (12), y la actividad grupal sobre el significado de los ejes (6). Atento a tratar lote y tiempo como el mismo tipo de eje: barajar un lote no hace daño y destruye un clip.
Batch no es tiempo. Dieciséis dígitos manuscritos barajados siguen siendo reconocibles, mientras que los fotogramas de vídeo barajados vuelven la secuencia de la tormenta irreconocible. Reordenar un eje de lote es seguro. Reordenar el tiempo no lo es.
Colab ↗
Esto es una demostración de código en vivo, no un bloque de discusión. Abre el cuaderno y ejecuta primero la celda de preparación; descarga y verifica por checksum el vídeo real que usan los ejercicios. Recalca el contraste entre barajar un lote y barajar el tiempo, y luego el lote rellenado con su máscara de validez.
03 · Indexación y broadcasting con datos reales
Practica hoy
Predecir formas de broadcasting y estandarizar columnas de píxeles de forma segura si la varianza es cero.
Explora después
Seleccionar observaciones con nombres de características, índices avanzados y máscaras booleanas.
Colab ↗
Modela el broadcasting 3 minutos con el ejemplo más pequeño, [[2, 10], [4, 14]] − [3, 12], con el simulador en el proyector: la sala predice la forma del resultado y después un desajuste que da error. El Ejercicio 3 y su retroalimentación tienen 11. Recoge la comprobación de un minuto antes de revelarla, y pregunta qué representa cada número de mean antes de dividir.
Indexación en acción: los mismos cuatro paneles de indexación, máscaras, recorte satelital y broadcasting, con una franja resumen que nombra cada técnica.
Colab ↗
04 · Reshape y transposición de imágenes reales
Practica hoy
Convertir HWC a CHW y comprobar que los valores de píxeles conservan su significado.
Explora después
Construir lotes de imágenes, comparar NHWC con NCHW e inspeccionar la disposición en memoria.
Colab ↗
Abre con una imagen diminuta que queda (3, 2, 2) dos veces, por una transposición y por un reshape, con el tensor de imagen en el proyector (2 min). El Ejercicio 1 tiene 7. Después la caza del error, 6: emparejar 2, prueba y puntuación 3, compartir 1. Nombra el reshape como el error de la apertura en frío.
transpose no es reshape: la misma comparación de histología entre transpose y reshape, más un lote real NHWC a NCHW con una imagen de histología, una foto de astronauta y una foto de gato, cada una reordenada correctamente.
Colab ↗
📖 Un tensor en Python puro ↗
Predicción: ¿sobrevive esta foto a un reshape?
El mismo error del arranque, ahora en una foto: reshape en vez de transpose sobre el mismo lote.
Abrir el widget de tensor de imagen ↗
Nómbralo como el error del arranque antes de mostrarlo: los números sobreviven, los ejes ya no significan lo que el código supuso.
En la pestaña Reshape (abierta por defecto), cambia al lote NHWC a NCHW y activa “Comparar con reshape”: y = los mismos bytes, releídos en orden de memoria y vertidos en esa forma. La imagen se rompe en franjas — los mismos bytes, los ejes equivocados.
Desactiva la comparación para mostrar el resultado correcto: un transpose reordena los ejes y no lee nada, así que la foto sobrevive. La pregunta con la que dejar la sala: ¿qué operación no lee nada, no mueve nada, y aun así acierta?
Kahoot 1 — Vocabulario de tensores y formas
Pausa activa: Kahoot 1, Vocabulario de tensores y formas. 6 preguntas sobre ejes, formas, indexación y transpose. Entrad en kahoot.it; respondan primero con intuición y luego justifiquen con formas.
Kahoot ↗
Ejecútalo antes de la pausa, justo después de la sección 04. Todos acaban de usar orden, eje, forma, varianza, reshape y transposición: es el momento en que esas palabras están más frescas. Una pregunta pide qué se obtiene al fijar todos los índices menos uno, una fibra, que solo cubre el Explora después de la sección 01. Da la definición en una línea cuando se revele la respuesta.
IMPORTA EL .xlsx CON ANTELACIÓN. Create → Add question → Import → Import spreadsheet. No lo hagas en directo.
Calcula 5 minutos incluido el podio. Los grupos quieren ver la clasificación, y está bien: es la recompensa.
Dos preguntas vienen de los ejercicios: la de los NaN es la de los píxeles de varianza cero de la sección 03, y la última es reshape frente a transposición de la sección 04.
Si vas muy justo de tiempo, este es el último cuestionario que hay que recortar: recorta antes el Kahoot 2.
05 · Diseño de un pipeline de vídeo
Practica hoy
Rastrear fotogramas muestreados hasta sus índices originales y defender un muestreo para un evento breve.
Explora después
Comparar pipelines completos, costes de relleno y organización de cámaras sincronizadas.
Colab ↗
Primero ¿Mito o hecho? (1 min). Después la predicción: ¿qué fotograma de origen es clip[1]? Es el 45, no el 1 (2 min), y el Ejercicio 1 (4). La actividad grupal 05 tiene 8: conserva el evento dentro del presupuesto, con una puesta en común de tres líneas en Discord. Con cinco minutos o más de retraso, informa un solo grupo.
¿Mito o hecho?
De vuelta de la pausa: tres afirmaciones de las secciones 02–04. Mano alzada para mito .
Barajar cuatro fotogramas deja su media igual.Hecho. 1,5 antes y después; por eso la media no puede decirte si el orden sobrevivió.
Si al estandarizar salen NaN, la fórmula tiene un error.Mito. Una columna que nunca varía tiene desviación típica 0; tres píxeles de los dígitos nunca varían.
Si una transposición y un reshape dan los dos forma (3, 2, 2), guardan los mismos valores en los mismos sitios.Mito. La misma entrada, [1, 0, 0], vale 1 tras la transposición y 4 tras el reshape.
Un minuto, mientras la sala se sienta. Es la pregunta de recuperación del bloque.
Lee cada afirmación y cuenta las manos para “mito”. Antes de revelar, pide a una persona un contraejemplo para una afirmación que la sala llamó mito. Después revela los veredictos uno a uno.
Hecho, y una trampa: los fotogramas [0, 1, 2, 3] barajados como [0, 3, 1, 2] conservan la media de 1,5, pero los pasos van de [1, 1, 1] a [3, -2, 1].
Mito: la fórmula dividió entre cero, y con razón. Una columna constante es un hallazgo sobre los datos, no un error.
Mito: la pregunta de predicción del cuaderno 04 y la lección de la caza del error.
Las tres son los errores resueltos 02, 03 y 04.
Archivo a frames a tensor a modelo: una tubería de cuatro etapas muestra cómo un vídeo se convierte en un tensor enmascarado, con la fórmula de la máscara de validez.
Colab ↗
06 · Contracción con einsum
Practica hoy
Contraer el color con einsum, nombrar los ejes restantes y verificar una suma ponderada de píxeles.
Explora después
Expresar operaciones matriciales con einsum y comparar medidas de similitud de dígitos.
Colab ↗
Modela una contracción durante 4 minutos: un píxel contraído a 21. El Ejercicio 1 y su retroalimentación tienen 10. Recoge la comprobación de un minuto antes de revelarla. Atento a las letras de salida: lo que falta a la derecha de la flecha se suma.
Anatomía de einsum: la expresión np.einsum(‘ij,jk->ik’, A, B) se descompone en sus etiquetas de entrada, el índice compartido y los índices que sobreviven, con un diagrama de las matrices que indexa cada letra.
NumPy y einsum: una tabla asocia producto interno, producto externo, matmul, transpose, traza, diagonal, matmul por lotes y suma por eje con su equivalente en einsum.
Colab ↗
07 · Inversas y la pseudoinversa
Practica hoy
Mostrar cómo columnas duplicadas dan predicciones idénticas con coeficientes distintos; explicar la elección de norma mínima de pinv.
Explora después
Verificar las cuatro identidades de Moore–Penrose, ajustar datos de vivienda y aplicar pinv a imágenes desplegadas.
Colab ↗
Primero ¿Mito o hecho? (1 min). Modela columnas duplicadas durante 3, con el paso de columnas colineales en el proyector, y después compara coeficientes y normas durante 8: las mismas predicciones con coeficientes distintos. Cierra con lo que los datos no pueden identificar, y la comprobación (3).
¿Mito o hecho?
De vuelta de la pausa: tres afirmaciones de las secciones 05–06. Mano alzada para mito .
clip[1] es lo segundo que pasó en el video.Mito. clip guarda uno de cada 45 fotogramas de 720, así que clip[1] es el fotograma 45.np.einsum('ii->', A) suma la matriz entera.Mito. Una letra repetida conserva solo la diagonal: 8 para [[5, 2], [7, 3]], cuyo total es 17.np.einsum('ij->', A) suma la matriz entera.Hecho. Dos letras distintas, las dos sumadas: 17.
Un minuto, mientras la sala se sienta. Es la pregunta de recuperación del bloque.
Lee cada afirmación y cuenta las manos para “mito”. Las afirmaciones 2 y 3 difieren en una letra, así que espera un voto dividido. Pide a alguien que votó “mito” en la 2 que diga qué entradas suma. Después revela los veredictos.
Mito: un índice sobre un eje muestreado es una posición en el array, no un momento. El 97,8% de los fotogramas grabados ni siquiera está en el tensor.
Mito: 5 + 3 = 8, no 5 + 2 + 7 + 3 = 17.
Hecho: qué letras se repiten decide qué entra en la suma.
Son los errores resueltos 05 y 06.
Mismas predicciones, coeficientes distintos
Para columnas duplicadas A = [x, x], las predicciones dependen de la suma de coeficientes.
(2, 0)2*x4
(0, 2)2*x4
(1, 1)2*x2
pinv(A) @ (2*x) elige (1, 1), la solución de norma mínima.
¿Qué sigue sin conocerse? Los efectos separados de las características duplicadas.
Colab ↗
Predicción: ¿cuánto se mueve la respuesta?
Mueve el objetivo un 2% y observa qué les pasa a los coeficientes cuando dos columnas dicen casi lo mismo.
Abrir el widget de colinealidad ↗
Haz clic en “90°: independientes” y pulsa el botón que mueve el objetivo un 2%. Las barras se mueven cerca de un 2% — los coeficientes siguen a los datos.
Ahora haz clic en “0.5°: casi paralelas” y pulsa el mismo botón otra vez: el mismo 2% de cambio en el objetivo ahora mueve los coeficientes más de un 300%. El número que hay que dejar en la sala: 2% de entrada, más de 300% de salida, en cuanto dos predictores son casi la misma columna.
Señala κ(X), impreso junto a las barras — el número de condición es la cota de cuánto puede empeorar.
California Housing y la pseudoinversa: un ajuste real de mínimos cuadrados de 20.433 por 7 — valores predichos frente a reales, e histograma de residuales — calculado con la pseudoinversa de Moore-Penrose.
Colab ↗
📖 Gira, estira y vuelve a girar ↗
¿Y los tensores? Tres tarjetas. La primera: no hay ninguna inversa tensorial de uso común. Es una pregunta legítima con una respuesta honesta, no un hueco en tu lectura. La segunda: sí existen definiciones, basadas en el producto de Einstein y en el t-producto para tensores de orden 3, y ambas son investigación activa. La tercera: en la práctica se despliega el tensor a matriz, se aplica la pseudoinversa matricial y se vuelve a plegar el resultado. Un tensor de 4 por 3 por 5 se despliega a 4 por 15, cuya pseudoinversa es 15 por 4. Y M A-más M devuelve M exactamente, porque el desplegado no pierde nada.
Aquí empieza también el hilo conductor de la segunda mitad: la pseudoinversa de la sección 07, Tucker en la sección 10 y la deconvolución de Richardson-Lucy en el ejercicio para casa 13 son tres casos de una misma idea — cuando un problema no tiene respuesta exacta ni inversa verdadera, se busca la mejor aproximación estable.
Colab ↗
📖 Inversas tensoriales en la práctica ↗
Extensión opcional tras la actividad de columnas duplicadas. Las cuatro identidades de Moore–Penrose y el ajuste de vivienda quedan para después.
Kahoot 2 — Einsum, distancia y la pseudoinversa
Pausa activa: Kahoot 2, Einsum, distancia y la pseudoinversa. 6 preguntas sobre einsum, similitud y la pseudoinversa. Entrad en kahoot.it; decidan primero la operación y luego justifíquenla con índices y formas.
Kahoot ↗
Ejecútalo justo después de la sección 07, antes de la demostración de recursión. Cubre la contracción (§06), la pseudoinversa y las matrices singulares (§07), y distancia/similitud: la matriz de similitud de dígitos del TODO 4 de la §06 es el puente entre ambas.
AVISO: dos preguntas son sobre distancia euclídea y similitud del coseno, que el manual no define directamente. Si no dijiste esas palabras durante la §06, espera que caigan en frío.
ESTE ES EL PRIMER CUESTIONARIO QUE HAY QUE RECORTAR si vas mal de tiempo: la pseudoinversa vuelve en la diapositiva de la idea única del cierre.
08 · Recursión con matrices y vectores
Practica hoy
Explicar una actualización de estado matricial y relacionar su repetición con una potencia de matriz.
Explora después
Usar iteración de potencias y evaluar pronósticos recursivos del tráfico aéreo.
Colab ↗
Abre con la imagen de Fibonacci: una regla, aplicada otra vez. Modela una actualización (3) y después el Ejercicio 1 y su comprobación (7).
09 · Factorizaciones matriciales
Practica hoy
Comparar residuos y sensibilidad de coeficientes; seguir coordenadas reducidas hasta la reconstrucción.
Explora después
Medir otras factorizaciones, comprimir imágenes con SVD e inspeccionar factores NMF.
Colab ↗
El Ejercicio 1 tiene 9, el error del residuo 3 y el puente de la SVD a Tucker 3. Sin barridos de tiempos. Con retraso a +2:30, omite el error del residuo, nunca el puente, que la sección 10 necesita.
Factoriza una vez, resuelve muchas: el mismo problema real de mínimos cuadrados de tres formas. Las ecuaciones normales son las más rápidas de escribir, y elevan al cuadrado el número de condición. QR es la opción estable por defecto, y nunca forma A-traspuesta-A. La SVD es la más cara y la más informativa, porque Eckart-Young da el error de truncamiento sin construir el truncamiento.
Colab ↗
📖 ¿Vectores propios o singulares? ↗
La tabla de operaciones y el cronómetro no coinciden, y ese desacuerdo es la lección. Lo que sobrevive a la máquina es la razón entre métodos a tamaño fijo: una SVD completa cerca de 39 veces una Cholesky. No el exponente, que queda por debajo de 3 por el paralelismo y la caché.
Si vas justo de tiempo, haz el ejercicio 2 y salta el 3.
10 · Descomposición de Tucker con datos reales
Practica hoy
Explicar formas del núcleo y factores, medir almacenamiento y error, y elegir rangos Tucker según un límite de error.
Explora después
Implementar HOSVD e inspeccionar desplegados, interacciones del núcleo y barridos de rangos.
Colab ↗
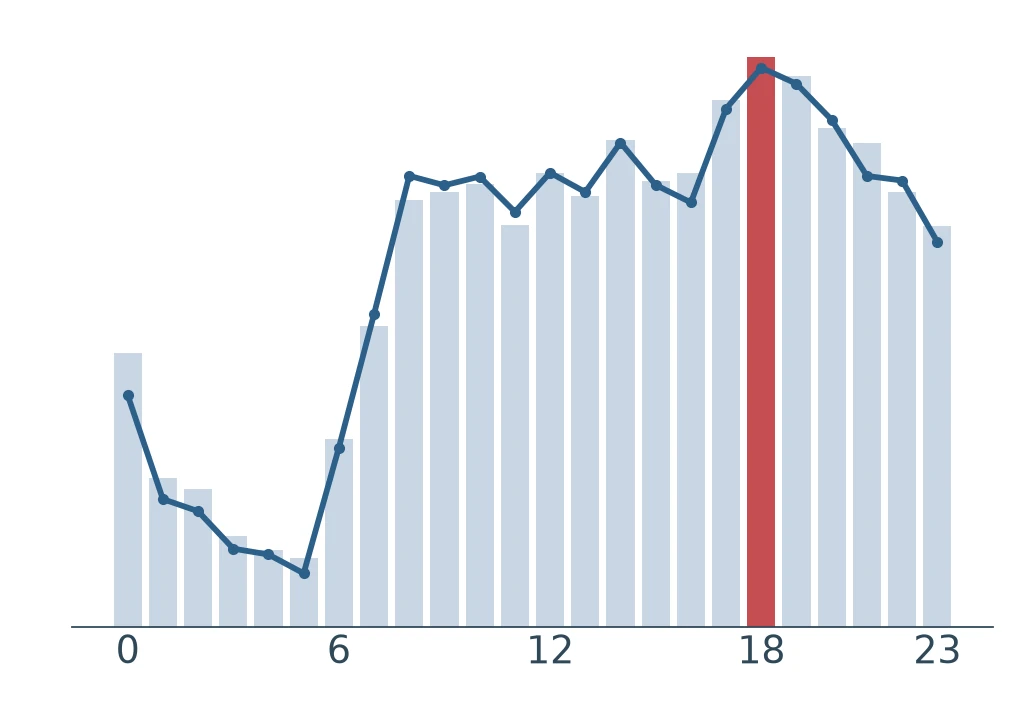
Primero ¿Mito o hecho? (1). Explica núcleo y factores (3), y después el golf de compresión, hoyo 1, en el explorador de rangos (8): el par es (3, 3, 1) con 60 números por debajo del 7%. Clasificación y defensa del ganador (3), y después el escenario de Tucker en los rangos ganadores, cuyo patrón horario tiene el pico en la hora 18. Nunca antes del golf, y nunca recortes esta sección.
¿Mito o hecho?
De vuelta de la pausa: tres afirmaciones de las secciones 07–09. Mano alzada para mito .
Si pinv devuelve una respuesta sin quejarse, la matriz era invertible.Mito. pinv responde para cualquier matriz. Con una columna duplicada responde para una matriz de rango 2, y P @ A no es la identidad.
Un pronóstico con un 1% de error a un paso puede errar más de un 3% a doce pasos.Hecho. Con w = 1.1, el error crece a 1% × 1,1¹² = 3,14%.
Dos ajustes pueden ser casi exactos y aun así discrepar en sus coeficientes.Hecho. Sus predicciones difieren en 0,000001 y sus coeficientes en 1,41.
Un minuto, mientras la sala se sienta. Es la pregunta de recuperación del bloque.
Lee cada afirmación y cuenta las manos para “mito”. Esta vez dos de tres son hechos; la sala esperará uno, como antes. Pide un contraejemplo para la afirmación 1 antes de revelarla.
Mito: comprueba el rango, no si apareció una excepción.
Hecho: un pronóstico recursivo se alimenta de su propia salida, así que la regla de actualización también se aplica al error. Con w = 0.9 se apaga.
Hecho: columnas casi colineales, la misma lección que la escena de colinealidad de la sección 07. Mira el condicionamiento además del ajuste.
Son los errores resueltos 07, 08 y 09.
Tabla a tensor a HOSVD a reconstrucción: una tubería de cuatro pasos convierte una tabla de viajes en un tensor de orden 3, calcula su núcleo y factores por HOSVD, y lo reconstruye mostrando el error.
Colab ↗
📖 Para qué sirve factorizar un tensor ↗
Nunca recortes la sección 10. En tecnología, Tucker y CP comprimen los tensores de pesos de las redes neuronales para que los modelos corran en móviles. En biotecnología, sobre datos (genes × muestras × condiciones), encuentran estructura que PCA no alcanza: PCA solo puede ver dos ejes.
Golf de compresión: hoyo 1
Guarda el tensor de taxis en el menor número de números posible, con un error relativo por debajo del 7% . Gana quien guarde menos.
Salida desde los rangos (2, 2, 3): 102 números, 6,70% de error.
El explorador de rangos imprime tu puntuación bajo sus mapas de calor.
Publica una línea: rangos · números · error.
Ocho minutos en el explorador de rangos: la actividad esencial del cuaderno 10 es el hoyo. Lleva la clasificación en la pizarra o en el chat, ordenada por números almacenados.
El par es (3, 3, 1): 60 números con un 4,69%. La mayoría de los equipos van a (2, 2, 3), luego a (2, 2, 2), luego a (2, 2, 1), y fallan: 46 números con un 7,14%. (3, 2, 1) y (2, 3, 1) también fallan, con un 7,13% y un 7,12%. Lo que gana es gastar rangos en los distritos, no en las horas. Desde (2, 2, 1), subir el rango horario a 3 gana 0,44 puntos de error; subir los dos rangos de distrito a 3 gana 2,45.
Si al minuto seis nadie baja de 70 números, pregunta: ¿qué rango no han probado a subir?
Predicción: ¿qué hora elige el factor de hora?
480 conteos de taxis se convierten en un núcleo pequeño y tres matrices factor. El cuaderno imprimió una hora; encuéntrala en la imagen.
Abrir el widget de Tucker ↗
Muéstralo después del golf, como evidencia para “defender al ganador”; nunca antes: la escena rotula el pico del factor de hora, y tanto la revelación del cuaderno como la última pregunta del Kahoot 3 tratan de esa hora.
En el proyector: pon los rangos de la entrada ganadora de la sala, normalmente (3, 3, 1): 60 números en lugar de 480, un ahorro de 8×, con un error del 4,69%. Queda un solo patrón horario, y su pico está en la hora 18, la que imprimió el cuaderno. La entrada ganadora conservó justo la forma diaria sobre la que se construyen los viajes. Dos herramientas, una respuesta. Haz clic en un vóxel del núcleo para mostrar qué patrón de origen, de destino y de hora pondera. Cambia la vista a reconstruido, y luego a residual, para mostrar lo que se pierde con la compresión.
Kahoot 3 — Convolución y descomposiciones tensoriales
Pausa activa: Kahoot 3, Convolución y descomposiciones tensoriales. 6 preguntas sobre convolución, correlación, Tucker y CP. Entrad en kahoot.it; reconozcan primero la estructura y luego elijan el operador.
Kahoot ↗
Ejecútalo justo después de la sección 10, con el resultado de la hora punta del tensor de taxis todavía en pantalla.
SU ÚLTIMA PREGUNTA NOMBRA LA HORA 18: tiene que ir DESPUÉS del explorador de rango de la §10, que imprime la hora más ocupada y la hora en la que alcanza su pico el primer patrón horario de Tucker, nunca antes, o revela la respuesta.
NUNCA RECORTES ESTE. Comprueba si Tucker ha calado mientras el resultado de los taxis sigue en pantalla. Pasa directamente del podio a la sección 11, que lleva el mismo tensor a CP.
11 · Factorizaciones tensoriales
Practica hoy
Comparar CP y Tucker sobre el mismo tensor mediante conteos de parámetros, errores de reconstrucción y diferencia de presupuestos.
Explora después
Estudiar Tensor Train y t-SVD, investigar unicidad de CP y comprimir capas de redes neuronales.
Colab ↗
Ejercicio 1 en parejas (7): CP y Tucker con un mismo presupuesto. Después el hoyo 2 del golf (5): la barra baja al 2%, y CP de rango 6 gana con 198 números frente a los 236 de Tucker. Clasificación y el escenario del presupuesto (3), nunca antes del ejercicio en parejas, que respondería.
Cuatro descomposiciones, cuatro tratos. CP guarda una suma de componentes de rango 1, R por I más J más K números, y es la opción cuando hay que leer los componentes uno a uno. Tucker guarda un subespacio por modo más un núcleo, y es la opción cuando cada modo necesita su propio rango. Tensor Train guarda una cadena de núcleos pequeños, que crece solo linealmente con el orden, y es la opción cuando un núcleo denso explotaría. Y t-SVD aplica una FFT sobre el modo 3, SVD matriciales y una FFT inversa, y es la opción cuando el tercer modo tiene un significado propio.
Colab ↗
📖 CP o Tucker ↗
Referencia opcional: Tensor Train y t-SVD quedan fuera de la comparación CP–Tucker de hoy. Vuelve a la actividad esencial durante el taller.
Golf de compresión: hoyo 2
Ahora vale cualquier modelo. Error relativo por debajo del 2% ; gana quien guarde menos.
golf("cp", 4) o golf("tucker", (4, 4, 3)) imprime una línea de puntuación.El hoyo 1 se ganó con 60 números. Esta barra cuesta más.
Publica tu mejor línea.
Cinco minutos para jugar y tres para la clasificación y la diapositiva siguiente.
El par es CP de rango 6: 198 números con un 1,76%. Lo mejor de Tucker es (4, 4, 5), 236 números con un 1,80%; (4, 4, 4) guarda 196 y falla con un 2,26%. CP de rango 5 también falla, con un 2,17%.
Pon los dos hoyos uno al lado del otro en la pizarra. Con el 7%, Tucker ganó con 60 números frente a los 66 de CP. Con el 2%, CP gana con 198 frente a los 236 de Tucker. El mismo tensor, los mismos dos modelos, y el ganador cambió. Después abre la escena del presupuesto.
Predicción: mismo presupuesto — ¿quién gana?
El mismo presupuesto de parámetros, gastado como CP y como Tucker — cuando las parejas ya tengan sus propios números.
Abrir el widget de presupuesto ↗
Guárdalo para la clasificación del golf, después de que las parejas hayan comparado sus propios ajustes de CP y Tucker: muestra los dos hoyos en una sola imagen, y mostrado antes les resuelve el ejercicio en parejas.
Pide a la sala que prediga antes de hacer clic: CP rango 3 y Tucker (3, 3, 3) — ¿cuestan lo mismo? No: CP rango 3 son 99 números, Tucker (3, 3, 3) son 126.
Baja el presupuesto a 66 parámetros: gana Tucker, 4,69% de error frente al 7,00% de CP. (El CP del cuaderno llegó al 6,73% ahí; el ajuste de la escena se detiene antes desde un único arranque, como muestra su escena de ALS.) A partir de 99 números, gana CP: el hoyo 1 se ganó a la izquierda de esa línea y el hoyo 2 a la derecha. El número que hay que dejar en la sala: quién gana depende del presupuesto, no de cuál es “mejor”.
Después lleva a la sala la pregunta del informe: dijo que CP era mejor “con rango 3”. ¿Qué mantuvo fijo, y qué guardaba de verdad cada modelo?
Solo si queda un minuto antes del resumen: el rango también tiene precio fuera de la compresión. La multiplicación de matrices es una contracción con un tensor fijo de ceros y unos, y el rango CP de ese tensor es el número de multiplicaciones que necesita. Para 2 × 2 es 7, el de Strassen, y por eso n³ pasa a ser n^2.807. Para 3 × 3 es un tensor 9 × 9 × 9 de 27 unos cuyo rango nadie conoce: está entre 19 y 23. Un rango 21 superaría a Strassen, y DeepMind ha lanzado AlphaTensor y AlphaEvolve contra el problema. La nota Sigue abierto al final de la sección 11 del manual tiene el código y los artículos.
Una idea conecta el taller
Aproximar estructura útil cuando la solución exacta no basta.
Pseudoinversa
Sección 07
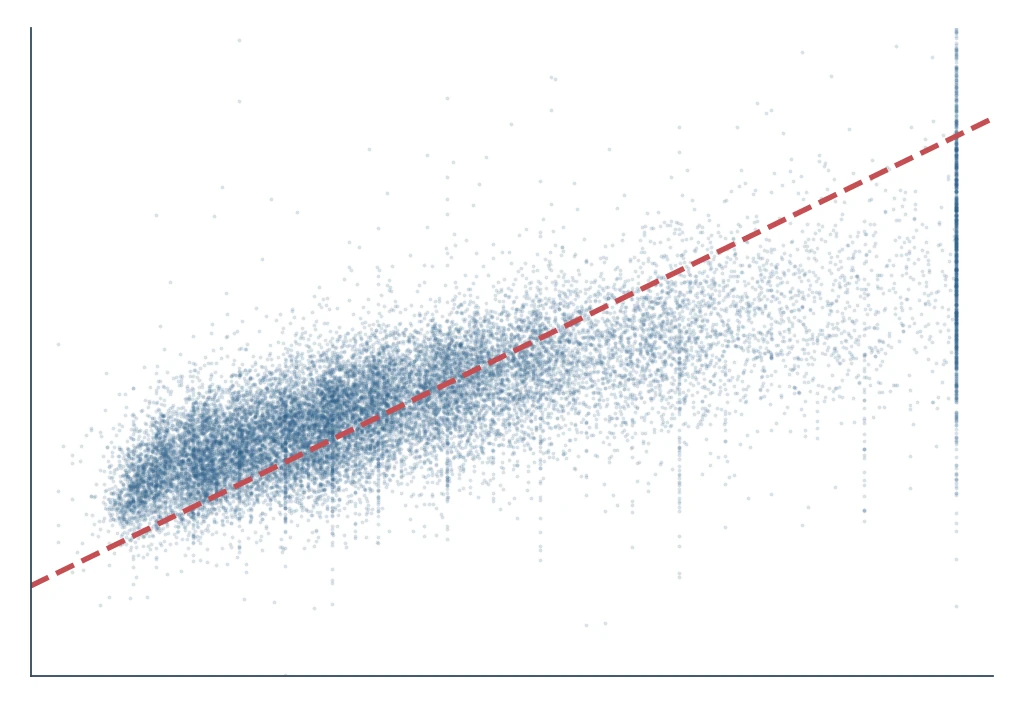
X.shape = (20433, 7): 20.433 ecuaciones, 7 incógnitas, sin solución exacta. pinv(X) @ y da el ajuste por mínimos cuadrados; la línea discontinua es una predicción perfecta.
Tucker
Sección 10
480 conteos de taxis guardados como 60 números, rangos (3, 3, 1), con un 4,69% de error. Viajes por hora, contados y reconstruidos: ambos alcanzan su máximo a las 18:00.
Deconvolución
Ejercicio para casa 13
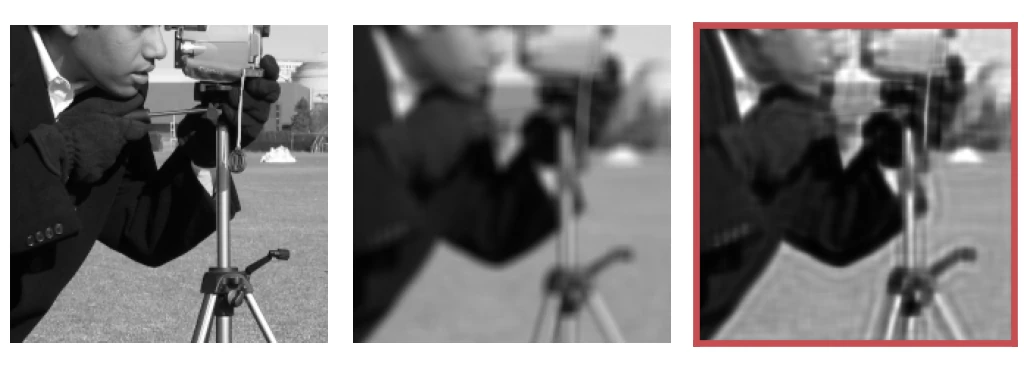
Un desenfoque conocido de 9 × 9, deshecho de forma aproximada: Richardson–Lucy, 20 iteraciones, error del 18,9% al 13,1%. Plausible, no exacta.
problema difícil → estructura → aproximación útil
Idea clave: no siempre buscamos exactitud algebraica; buscamos una representación que conserve lo importante.
Colab ↗
Enunciar esta conexión de forma explícita es lo que hace que la segunda mitad se sienta como una sola lección y no como cuatro bloques sueltos. No te lo saltes. La diapositiva de inversas tensoriales de la sección 07 la abre; aquí se cierra.
Cada número de la diapositiva es uno que la sala imprimió: X.shape en el Ejercicio 2 de la sección 07, el par del hoyo 1 en el golf de la sección 10 y el Ejercicio 3 del ejercicio para casa 13.
La convolución es la única de las tres patas que la sala ya no ejecuta. Dilo, y di que el ejercicio para casa 13 es donde le ocurre a una fotografía real.
Callback de 30 segundos al arranque, dentro de este repaso: reproduce otra vez la voz transpuesta de la primerísima diapositiva. Deja que la sala nombre el error: un reshape o un transpose hecho sin preguntar qué significa cada eje. Luego vuelve a “como la construyó la transformada” y déjala sonar limpia. Es la misma idea, oída dos veces.
12 · Cierre y ejercicios para casa
Practica hoy
Aplicar razonamiento sobre ejes a datos nuevos y explicar por qué Tucker recupera la forma mientras pierde información.
Explora después
Elegir trabajo posterior sobre PCA, atención, CP, Cholesky, audio o los estudios 13–16.
Colab ↗
📖 Por fin entendí Fourier ↗