10 Un solo conjunto de resultados
Quarto, publicación reproducible, agentes de programación, Markdown, Python, EPUB, análisis de datos, k-means
La vía rápida terminó con un informe. Una evaluación real tiene más lectores que eso. El equipo de producto quiere el titular y la tabla; quien revisa riesgos o cumplimiento quiere saber a quién trata de forma distinta el modelo y para qué no debe usarse; quien invierte quiere un número que se movió. La manera de servirles a todos sin que los números se separen es el diseño que el repositorio ya tiene: un script calcula cada resultado una sola vez, y todos los documentos los leen. Este capítulo agrega el segundo documento, una ficha del modelo (model card), y hace crecer el informe, y muestra cómo darle a un agente una tarea más grande sin riesgo: pidiendo primero un plan y juzgando después el resultado por sus comprobaciones.
Es el primer capítulo de esta parte, cuyos capítulos toman cada uno un tipo de salida, aquí una ficha del modelo y luego diapositivas, un sitio y un white paper, y lo enseñan de la misma manera: qué puede hacer y cómo se llama, cómo pedirlo y cómo revisarlo (la Sección 2.7).
- Explicar por qué los resultados se calculan una sola vez y los leen todos los documentos, y qué atrapa cada tipo de comprobación (las pruebas, las guardas, el renderizado).
- Pedirle a un agente una ficha del modelo como una sola tarea más grande, con un plan primero, y juzgarla por sus comprobaciones.
- Numerar las secciones y referirse a ellas, a las tablas y a las figuras, de modo que cada referencia se resuelva en HTML, Word y PDF.
- Predecir qué le hace a cada documento un ajuste cambiado, y luego reconstruir y revisar.
10.1 Calcular una vez, comprobar de tres maneras
scripts/evaluate.py es el único código del repositorio que ajusta un modelo. Escribe cinco archivos de texto plano en outputs/, y son los mismos bytes en cada ejecución, porque cada elección aleatoria, la división de los datos, los modelos y el bootstrap, tiene una semilla fija. En la ejecución de este libro:
| Archivo | Contiene |
|---|---|
summary.json |
la mejor versión (v3), el tamaño del conjunto de prueba (11,303), la tasa base (11.7%), las semillas, la suma de verificación de los datos y las versiones de los paquetes |
metrics.csv |
las métricas de cada versión, con un intervalo bootstrap del 95% |
segments.csv |
lo mismo por franja de edad y por ocupación |
calibration.csv |
las tasas predichas frente a las observadas, en diez intervalos |
curves.csv |
los puntos de las curvas ROC y de precisión-recall |
Luego, tres tipos de comprobación protegen cosas distintas, y un repositorio profesional necesita los tres:
| Comprobación | Se ejecuta | Atrapa |
|---|---|---|
Pruebas (uv run pytest) |
sobre el código y los datos | un archivo de datos cambiado (su suma de verificación), una fuga de información (ninguna versión puede usar duration, que solo se conoce después de la llamada), una métrica equivocada, salidas a las que les falta una columna |
Guardas (claim(…) en un documento) |
cuando se renderiza un documento | una oración cuyas palabras los resultados ya no respaldan: “best”, “most”, “within five points” (la mejor, la mayor, a menos de cinco puntos) |
| El renderizado | en cada documento, en cada formato | una referencia que no se resuelve, un archivo que falta, una celda que falla |
Una prueba no lee la prosa, y una guarda no prueba el código; ninguna de las dos nota una etiqueta escrita a mano que quedó desactualizada, algo que solo nota quien lee, o una predicción puesta a prueba con una reconstrucción (la Sección 10.4).
10.2 Una ficha del modelo, como una tarea más grande
Una ficha del modelo es un documento breve que acompaña a un modelo: qué es, para qué sirve y para qué no, cómo se desempeña en general y en los grupos a los que afecta, y qué saben quienes lo hicieron que está mal en él. Mitchell y colegas propusieron el formato en 2019, con una lista fija de secciones, que es el vocabulario para pedirla.
La ficha es un buen ejemplo de una tarea para entregar entera (la Sección 2.8): puedes enunciar el resultado (esas secciones, a partir de esos archivos), y sus comprobaciones se ejecutan sin ti (las guardas, las referencias, el renderizado). Así que pide primero un plan, léelo, y solo entonces deja que el agente trabaje. Empieza una rama para ella, como para cualquier cambio que vayas a revisar:
git switch -c model-cardPrimero un plan, y espera mi visto bueno: agrega model-card.qmd (html, docx y typst), escrita en inglés, para la mejor versión, con las secciones de Mitchell et al. (2019), "Model Cards for Model Reporting": detalles del modelo, uso previsto, factores, métricas, datos de evaluación, datos de entrenamiento, análisis cuantitativos, consideraciones éticas, y advertencias y recomendaciones. Lee solo outputs/ y data/README.md. Las métricas por subgrupo, por franja de edad y por ocupación, salen de outputs/segments.csv, y la calibración de outputs/calibration.csv. Cita el artículo y el conjunto de datos desde un references.bib nuevo, abriendo antes cada DOI. Protege con `claim` cada oración cuya redacción dependa de los resultados. Renderiza los tres formatos y luego enumera lo que no pudiste verificar.responde con un plan · tras tu visto bueno: escribe references.bib y model-card.qmd · uv run quarto render model-card.qmd
Lee el plan como lo haría quien revisa. Uno bueno enumera las secciones en orden, dice de dónde sale cada número, nombra los subgrupos y la figura, y dice cómo va a revisar las referencias; en la ejecución de prueba también prometió calcular la etiqueta “top 10%” a partir de outputs/ en lugar de escribirla a mano. Si al plan le falta algo, dilo antes de que empiece; es más barato cambiar un plan que un archivo. Luego responde Go ahead. (adelante).
Cuando termina, las comprobaciones son las que pidió el prompt:
- Las guardas. Lee cada
claim(…)del archivo: cada una debe enunciar una oración de la ficha, y su condición debe calcular esa oración a partir deoutputs/. Una guarda cuya condición nunca puede ser falsa, como un nombre leído de los resultados comparado consigo mismo, no protege nada. - Las referencias.
references.bibdebe tener a Mitchell et al. y el conjunto de datos, cada uno con un DOI que puedas abrir. En la ejecución de prueba, el registro del DOI del conjunto de datos tenía los autores mezclados, y el agente citó el conjunto de datos tal como lo da la propia página del repositorio de datos: una razón para abrir los DOI, no solo para juntarlos. - La lista de lo que no pudo verificar. Es la parte más útil del informe de una tarea más grande. La lista de la ejecución de prueba nombraba cómo se hizo la división, cómo se formaron los intervalos de calibración y que el texto del uso previsto y de la ética era un encuadre suyo. Cada elemento es una pregunta para ti, no un defecto que aceptar.
- El renderizado. Abre los tres formatos, y mira los subgrupos como los mirarían las personas que los forman.
Los subgrupos de la ficha terminada dejan clara la idea del ejercicio. Con v3, el 10% superior de la lista, al que se llama, contiene el 47.9% de los contactos de la franja 60+, pero el 5.0% de los de la franja 40-49: el modelo ordena por edad, porque en estos datos la franja 60+ es la que se suscribe con más frecuencia (38.8%). Eso es exacto, y es justamente lo que una ficha debe decir, porque la edad es una característica protegida por la ley del Reino Unido, y un banco que decide a quién llamar necesita saberlo antes de confiar en el ordenamiento.
| Franja de edad | Contactos de prueba | Llamados | Tasa de suscripción | Recall |
|---|---|---|---|---|
| 18-29 | 1,337 | 20.0% | 17.1% | 51.8% |
| 30-39 | 4,512 | 8.2% | 10.7% | 37.9% |
| 40-49 | 2,953 | 5.0% | 8.6% | 32.0% |
| 50-59 | 2,102 | 7.4% | 9.7% | 41.9% |
| 60+ | 399 | 47.9% | 38.8% | 70.3% |
Tres trampas con las que se topó la ejecución de prueba. Las tablas con estilo de pandas (df.style) necesitan el paquete jinja2, que el repositorio no tiene, así que el primer renderizado se detuvo; el agente escribió la tabla de otra manera en lugar de agregar una dependencia, que es la opción preferible. Sin un ajuste, las citas del PDF salieron con un estilo distinto al de HTML y Word, con un título “References” vacío y una segunda página “Bibliography”, porque Quarto le entrega las citas de un PDF de Typst al procesador propio de Typst; citeproc: true bajo typst: hace que los tres formatos usen el mismo (la Sección 10.3). Y un renderizado fallido deja el model-card.html anterior donde estaba, así que lee las últimas líneas del renderizado antes de abrir el archivo.
10.3 Secciones, números y referencias
El informe suma dos secciones, y quien lee un documento en tres formatos necesita encontrarlas. Las secciones numeradas y las referencias cruzadas lo hacen posible, y cada una es un ajuste o una etiqueta:
| Pides | La función de Quarto | Se renderiza como |
|---|---|---|
| secciones numeradas | number-sections: true |
“2 Who is called” |
| una referencia a una sección | ## Who is called {#sec-segments} y @sec-segments |
“Section 2”, un enlace |
| una referencia a una tabla o una figura | una celda con la etiqueta tbl-… o fig-…, y @tbl-… |
“Table 2”, “Figure 2” |
| el mismo estilo de cita en todos los formatos | bibliography:, y citeproc: true para typst |
“(Mitchell et al. 2019)” en los tres |
En report.qmd, numera las secciones y agrega dos, en inglés: a quién se llama (el recall en el 10% superior por franja de edad, de outputs/segments.csv, como una tabla con la etiqueta `tbl-segments`) y la calibración (una figura con la etiqueta `fig-calibration` a partir de outputs/calibration.csv), cada una con una guarda donde su redacción dependa de los resultados, y refiérete a las dos desde el párrafo inicial con referencias @sec-. Renderiza los tres formatos y comprueba que ninguna referencia cruzada muestre "??".edita report.qmd · uv run quarto render report.qmd
La comprobación está en el prompt: una referencia sin resolver se renderiza como “??”, en todos los formatos, así que búscalo en cada salida. En la ejecución de prueba, el párrafo inicial se leía igual en HTML, Word y PDF, y terminaba con “Section 2 shows who is called, by age band, and Section 3 whether the predicted probabilities match the rates observed” (la Sección 2 muestra a quién se llama, por franja de edad, y la Sección 3, si las probabilidades predichas coinciden con las tasas observadas).
La calibración pregunta si una probabilidad predicha puede leerse como una tasa: de los contactos a los que el modelo les da un 20%, ¿se suscribe más o menos uno de cada cinco? La Figura 10.1 la dibuja para la mejor versión, a partir del mismo archivo que lee el informe.
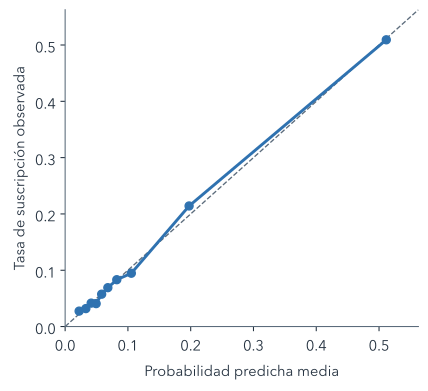
Con v3, ningún intervalo se aleja más de 1.7 puntos porcentuales de la diagonal; con la versión más antigua, la mayor distancia es 5.7. El informe dice con una guarda qué versión está mejor calibrada, porque esa palabra, a diferencia de los números, no se deriva sola de los datos.
Cuando los dos documentos se rendericen, revisa la rama como en la Sección 3.7: el alcance (model-card.qmd, references.bib, report.qmd, quizá AGENTS.md), un número contra outputs/, y un clon nuevo. Luego haz commit.
¿Dos minutos sin avanzar? Pega esto en tu agente. Respalda tu trabajo y lleva el proyecto hasta este punto; luego sigue leyendo desde aquí.
Catch me up: follow ../quarto-workshop/checkpoints/15-eval-results/README.md10.4 Cambia un ajuste, explica la reconstrucción
El centro de llamadas tiene capacidad para más llamadas. No hay un prompt: esta es la prueba del diseño, y puedes hacerla a mano.
¿Qué debería cambiar, qué no, y cuál es la trampa?
La cantidad de llamadas (a 2,261), y con ella cada métrica de la parte superior de la lista: el recall, la precisión, el lift y la proporción llamada de cada franja. El ROC AUC, la precisión promedio, la puntuación de Brier, la calibración y la mejor versión no cambian: miden el ordenamiento completo, no dónde se corta. La trampa es todo lo que nombra la proporción con palabras. En la ejecución de prueba, un informe escrito sin guardas sobre esas palabras conservó “top 10%” en el pie de una tabla y en dos etiquetas de fila, junto a las cifras nuevas, y los nombres de las métricas en outputs/, entre ellos recall_top10, también siguieron diciendo 10. En el proyecto terminado, las etiquetas calculan la proporción, y cada pie que la nombra, que no puede calcularla, tiene una guarda: los dos documentos se detienen con “The caption says top 10%, which a caption cannot compute” (el pie dice top 10%, algo que un pie no puede calcular). Dos pruebas unitarias de tests/test_metrics.py también fallan, porque fijan la regla del 10%; es una prueba haciendo su trabajo, y cambiar la proporción implica actualizarlas a propósito. En la ejecución de prueba, la propia ficha del agente también se detuvo en una guarda sobre las ocupaciones a las que menos llegan las llamadas, el tipo de oración que una lista duplicada sí cambia.
Resumen
- Un script calcula cada resultado una sola vez en archivos de texto plano; todos los documentos los leen, así que quien revisa puede confiar en que el informe y la ficha citan la misma ejecución.
- Las pruebas revisan el código y los datos, las guardas revisan la prosa y el renderizado revisa las referencias; ninguna ve una etiqueta escrita a mano, algo que sí revelan una predicción y una reconstrucción.
- Una ficha del modelo tiene un conjunto fijo de secciones, que es el vocabulario para pedirla; sus subgrupos son donde se nota el efecto de un modelo en las personas.
- Dale a un agente una tarea más grande con un plan primero, y luego juzga el resultado por sus guardas, sus referencias, su lista de lo que no pudo verificar y el renderizado.
- Las secciones numeradas y las tablas y figuras con etiqueta dan referencias que se resuelven en todos los formatos;
citeproc: truehace que un PDF de Typst cite como los demás.
El proyecto ya tiene dos documentos para quienes leen. Su próximo público va a estar en una reunión, frente a una pantalla.
Lecturas adicionales
- Margaret Mitchell y colegas, Model Cards for Model Reporting, Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* ’19), 220–229 (consultado el 2026-11-18).
- Quarto, Referencias cruzadas y Citas (consultados el 2026-11-18).
- Gobierno del Reino Unido, Equality Act 2010, sección 4: las características protegidas, entre ellas la edad (consultado el 2026-11-18).
- S. Moro, P. Cortez y P. Rita, A data-driven approach to predict the success of bank telemarketing, Decision Support Systems 62 (2014), 22–31: el estudio detrás de los datos (consultado el 2026-11-18).