21 Interpretar los clústeres
Quarto, publicación reproducible, agentes de programación, Markdown, Python, EPUB, análisis de datos, k-means
El clúster 4 es un número, y sobre un número es difícil actuar. “Rural, baja cobertura, agua de riesgo alto” es una frase que un funcionario puede repetir y sobre la que un concejo puede discutir, y cualquiera puede revisarla, siempre que la haya producido una regla y no el ojo de alguien. Los nombres son lo que más pesa en la comparación para la que se construyó el análisis: la mortalidad infantil, los puntajes de los exámenes y la deserción escolar, que el agrupamiento nunca vio, tipo por tipo. En esa comparación es donde los lectores sacan conclusiones, así que es donde más importa la honestidad, y tiene tres vistas, porque cada una esconde algo que las otras muestran.
- Leer el mapa de calor de los perfiles y describir un clúster por las características que lo distinguen.
- Explicar la regla que le pone nombre a cada clúster, y revisar un nombre contra el perfil y contra un miembro, Tunja.
- Comparar las variables de resultado entre los tipos por año, en unidades de desviación estándar y como distribuciones, y decir por qué cada brecha es una descripción, no un efecto.
- Agregar el mapa de calor y las líneas de las variables de resultado a la página de los clústeres.
21.1 Qué distingue a cada clúster
El perfil de un clúster es la media de cada característica sobre sus filas, en unidades z (Sección 19.1): +1 significa una desviación estándar por encima del promedio de ese año en todas las filas conservadas (Figura 21.1). Lee a lo largo de la línea de un clúster para describirlo, y a lo largo de la línea de una característica para ver qué característica separa a los clústeres.
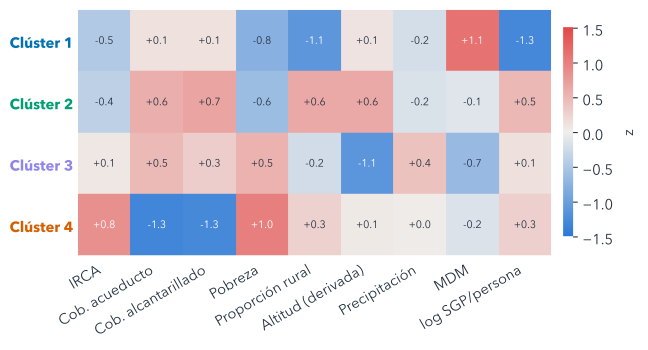
El clúster de IRCA más alto, el clúster 4, se destaca en tres cosas a la vez: cobertura de acueducto (−1.3 DE), pobreza (+1.0 DE) y IRCA (+0.8 DE). Cada clúster es una combinación así, que es exactamente lo que una sola variable no habría podido encontrar.
21.2 Ponerles nombre con una regla
Los nombres hacen que los clústeres se puedan usar, y también los hacen persuasivos, así que necesitan una regla que cualquiera pueda revisar. La función name_rule() del script del análisis arma cada nombre a partir de tres partes (el script los escribe en inglés; este libro los traduce):
- Entorno, probado en este orden: “Rural” si menos del 40% de las filas del clúster son zonas urbanas; si no, “Ciudades y pueblos grandes” si su proporción rural está 0.5 DE o más por debajo del promedio, “Pueblos de tierras bajas” si su altitud está 0.5 DE o más por debajo, “Pueblos de tierras altas” si está 0.5 DE o más por encima, y simplemente “Pueblos” si no se cumple nada de esto.
- Cobertura: “baja cobertura” si la cobertura de acueducto media del clúster está 0.5 DE o más por debajo del promedio.
- Riesgo: el nivel de la Resolución 2115 de la mediana del IRCA de prestadores del clúster, el valor del medio cuando sus zonas-año se ordenan por IRCA.
| Tipo | Zonas-año | Municipios | Mediana del IRCA (0–100) | |
|---|---|---|---|---|
| 1 | Ciudades y pueblos grandes, agua sin riesgo | 2,271 | 284 | 1.6 |
| 2 | Pueblos de tierras altas, agua sin riesgo | 3,750 | 558 | 4.0 |
| 3 | Pueblos de tierras bajas, agua de riesgo bajo | 2,451 | 479 | 9.2 |
| 4 | Rural, baja cobertura, agua de riesgo alto | 2,763 | 729 | 35.2 |
Como la regla lee el perfil, los nombres nunca dependen del número que k-means le haya tocado darle a un clúster. Dos palabras de los nombres requieren cuidado. “Baja cobertura” es una posición relativa, no absoluta: la cobertura media del clúster rural es del 30%, baja pero no cero, así que “sin servicio” sería exagerar. Y la palabra del riesgo describe la mediana del clúster, no cada zona-año que contiene: las zonas-año individuales pueden estar en cualquier nivel, y una mediana cerca del borde de un nivel puede cambiar la palabra.
Revisa cada nombre contra el mapa de calor y la tabla de perfiles antes de usarlo, y mantén la regla al lado del nombre en todo lo que publiques. Un nombre es un resumen que otra persona va a citar sin la tabla. Los umbrales, el 40% y media desviación estándar, también son elecciones: uno distinto podría cambiar un nombre.
El agua rural de Tunja puntuó en el nivel de riesgo alto en sus primeros años (Sección 18.3). Antes de seguir leyendo, ¿en qué clúster esperas que caiga su zona rural, y qué podría ponerla en otro?
El clúster rural es la apuesta obvia. Pero k-means ubica una zona-año según las nueve características a la vez, y varias de ellas, como la proporción rural y la altitud, pertenecen al municipio, así que son iguales para las dos zonas de Tunja. Si esas quedan lejos del centro del clúster rural, pueden pesar más que el agua.
21.3 Dónde cae Tunja
El clúster que contiene las 16 zonas-año de Tunja, urbanas y rurales, ahora tiene nombre: el clúster 1 (ciudades y pueblos grandes), “Ciudades y pueblos grandes, agua sin riesgo”. Para la zona urbana, encaja. Para la zona rural, la etiqueta esconde casi todo lo que encontró la Sección 18.3. Su agua puntuó en el nivel de riesgo alto todos los años de 2010 a 2014, antes de que se abra la ventana del análisis en 2016, y dentro de la ventana su IRCA de prestadores nunca está en el nivel sin riesgo, y está en el nivel medio en tres de los ocho años.
Hay dos cosas en juego. La palabra del riesgo describe la mediana del clúster, no a cada miembro, como advirtió la Sección 21.2. Y k-means pone cada zona-año en el clúster cuyo centro está más cerca sobre las nueve características a la vez (Sección 20.1), sumando las diferencias al cuadrado característica por característica. La Tabla 21.2 divide esa suma en dos. En sus cuatro características propias, IRCA, cobertura de acueducto, cobertura de alcantarillado y pobreza, la zona rural de Tunja queda más cerca del centro del clúster 4 (rural), y dos de ellas, las coberturas, son rellenos (Sección 19.2). Las otras cinco, proporción rural, altitud, precipitación, desempeño municipal y transferencias para agua, son del municipio, iguales para las dos zonas. En esas queda mucho más cerca del centro del clúster 1, lo bastante como para pesar más que las primeras cuatro. Los otros dos centros están todavía más lejos.
| Característica | Tunja, rural | Centro 1 | Centro 4 |
|---|---|---|---|
| IRCA | −0.2 | −0.5 | +0.8 |
| Cobertura de acueducto (llenada) | −1.1 | +0.1 | −1.3 |
| Cobertura de alcantarillado (llenada) | −1.4 | +0.1 | −1.3 |
| Pobreza | +0.3 | −0.8 | +1.0 |
| Distancia al cuadrado, sus cuatro propias | 5.0 | 1.7 | |
| Proporción rural | −2.1 | −1.1 | +0.3 |
| Altitud | +1.6 | +0.1 | +0.1 |
| Precipitación | −1.3 | −0.2 | +0.0 |
| Desempeño municipal | +1.5 | +1.1 | −0.2 |
| Transferencias para agua | −2.3 | −1.3 | +0.3 |
| Distancia al cuadrado, las cinco compartidas | 5.4 | 18.8 | |
| Distancia al cuadrado, las nueve | 10.5 | 20.5 |
No está sola: el 33% de las zonas-año de ese clúster son zonas rurales. Una etiqueta describe un tipo; para decir algo sobre un miembro, vuelve a sus filas.
21.4 Las variables de resultado por clúster
Ahora, las variables de resultado, que el agrupamiento nunca usó (Figura 21.2). Cada línea es la mediana de un clúster dentro de cada año, así que un desplazamiento que mueve todos los tipos en un año no puede pasar por una diferencia entre tipos. La mortalidad infantil se compara solo en 2017–2019 y 2021–2023: su método cambia en 2017, y 2020 parece venir de otra fuente (el README de los datos, advertencia 8).
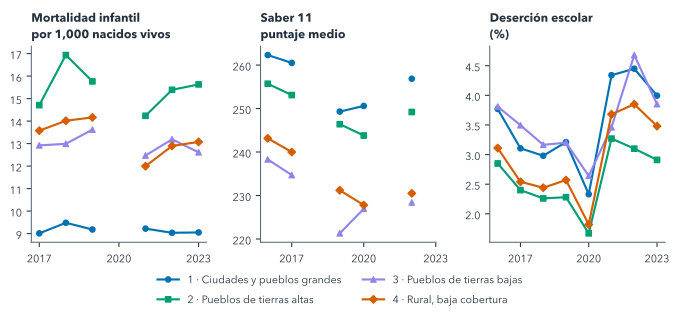
Los huecos en las líneas son años sin un valor comparable, dibujados como huecos y no unidos. La mortalidad infantil y la deserción se miden para todo el municipio pero se repiten en las filas de las dos zonas, así que se cuentan una vez por municipio en cada clúster y año: para estas dos, la unidad es el municipio-año, un municipio en un año, mientras que las características y Saber 11 siguen siendo por zona-año.
La Figura 21.3 pone las variables de resultado en la escala de las características: cada variable de resultado estandarizada dentro de su año, y cada celda es el z medio del clúster, con la media en sí entre paréntesis.
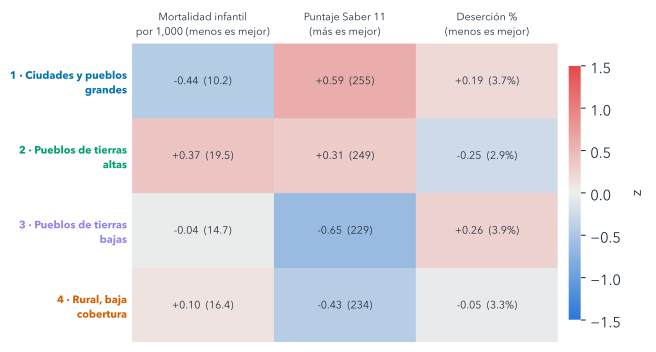
Lo pálido es el hallazgo. La media de ninguna variable de resultado de ningún clúster está a más de 0.65 desviaciones estándar del promedio, frente a 1.32 en las características que los formaron: los tipos difieren menos en las variables de resultado que en lo que los define. En parte, esto es por diseño: k-means eligió los clústeres para separar las características, así que deberían diferir más en esas que en cualquier otra cosa. Dentro de eso: la mortalidad infantil registrada más baja está en el clúster 1 (ciudades y pueblos grandes) y la más alta en el clúster 2 (pueblos de tierras altas); los mejores puntajes de Saber 11 están en el clúster 1 (ciudades y pueblos grandes); y la deserción más baja, en el clúster 2 (pueblos de tierras altas).
Supón que el agua insegura sí dañara mucho la salud de los bebés. ¿Seguirías esperando que el mapa de calor de las variables de resultado fuera más pálido que el de las características?
Sí. k-means eligió los clústeres para separar las características, así que difieren más en esas por construcción. Las variables de resultado difieren solo en la medida en que van de la mano con las características, y las tasas ruidosas de los lugares pequeños las desdibujan todavía más. Lo pálido, por sí solo, no es evidencia de que el agua no importe.
La mortalidad infantil registrada más alta no está en el clúster con la peor agua, el clúster 4 (rural). Es un buen momento para ir más despacio en lugar de buscarle una explicación fácil, porque dos cosas de los datos empujan en la misma dirección. La primera son los números pequeños. Las tasas del clúster 2 (pueblos de tierras altas) vienen de los lugares más pequeños de todos los tipos, una mediana de 10,680 personas por municipio-año, donde un puñado de muertes mueve mucho una tasa.
La segunda es lo que falta. Desde 2017, la serie parece de tasas observadas y no de estimaciones modeladas, así que un municipio donde no murió ningún bebé ese año debería mostrar una tasa de 0, y sin embargo no aparece ningún cero: un vacío puede ser un cero registrado. El 50% de los municipios-año de este tipo está vacío, frente al 32% de todos los municipios-año agrupados. Dejar fuera los vacíos descarta lo que pueden ser ceros, lo que sube sobre todo los promedios de los lugares pequeños. Eso es selección según la variable de resultado: que una fila se conserve depende del valor que se está midiendo, así que las filas conservadas no son típicas. Puede explicar parte del lugar de este tipo en lo más alto. Los números pequeños, el registro y muchas otras diferencias entre los tipos están todos entre el agua de un clúster y sus variables de resultado, y el Capítulo 22 se ocupa de eso directamente.
21.5 Cada variable, clúster por clúster
Las medias y las medianas esconden la superposición. Los diagramas de caja la muestran: cómo se dispersa cada variable dentro de cada clúster (Figura 21.4). Cada caja contiene la mitad central de los valores de un clúster, con una línea continua en la mediana y una línea discontinua en la media, y sus bigotes van del percentil 5 al 95, así que abarcan el 90% central de los valores. Las características cubren cada zona-año de 2016–2023; las variables de resultado cuentan en sus años, las municipales una vez por municipio.


Las cajas hacen visible la superposición. Los clústeres difieren mucho en las características que los construyeron y se superponen en las variables de resultado, y una brecha entre las cajas de dos clústeres es una descripción de los datos, no un efecto de la calidad del agua.
Así que la segunda pregunta del análisis del agua tiene una respuesta, y es descriptiva: la mortalidad infantil, los puntajes de los exámenes y la deserción sí difieren entre los tipos de lugar, los puntajes del examen más que nada, pero en no más de 0.65 desviaciones estándar en la media de ningún clúster, y en cada variable de resultado el 90% central de los valores de cada tipo se superpone con el de todos los demás.
21.6 Construir la interpretación
La ruta normal copia las reglas de las variables de resultado y los nombres terminados, como en la Sección 20.5:
Copia ../quarto-workshop/checkpoints/08-water-interpret/scripts/analysis.py sobre scripts/analysis.py (guarda el mío como scripts/analysis-before-08.py), ejecútalo con `uv run python scripts/analysis.py` y muéstrame los nombres de los clústeres.copia · ejecuta · escribe outputs/outcomes_by_year.csv y outputs/cluster_profiles.csv
Debería mostrar cuatro nombres, en inglés, los de la Tabla 21.1.
Para construirlos (opcional), dos prompts: las reglas de las variables de resultado, y luego los perfiles y los nombres.
En scripts/analysis.py, agrega reglas para las variables de resultado: infant_mortality solo en 2017–2019 y 2021–2023; infant_mortality y dropout_rate son municipales, así que cuenta cada municipio una vez por `cluster` y `year`; saber11_mean sigue siendo por zona-año. Guarda outputs/outcomes_by_year.csv (median, n). Ejecútalo.Escribe outputs/cluster_profiles.csv: filas, municipios, características medias originales y z, medianas de las variables de resultado y n con las mismas reglas. Ponle nombre en inglés a cada clúster con una regla: entorno, cobertura relativa ("low-coverage" si la media de z_water_coverage ≤ −0.5), nivel de la mediana del IRCA. Muéstrame los nombres.Sea cual sea la ruta que tomaste, outputs/outcomes_by_year.csv no debería tener filas de mortalidad infantil para 2016 o 2020: las reglas conservan solo los años cuyo método coincide.
Las dos rutas agregan luego la interpretación a la página de los clústeres:
Agrega a clusters.qmd un mapa de calor de los puntajes z medios de los clústeres (características × clústeres, de azul a rojo) y un gráfico de líneas por variable de resultado a partir de outputs/outcomes_by_year.csv, con huecos, no líneas unidas, en los años faltantes. Usa los nombres y los colores de los clústeres. Renderízalo.recargas clusters.html en tu navegador
La página debería mostrar el mapa de calor, cuatro clústeres por nueve características, y un gráfico por variable de resultado, con las líneas de la mortalidad infantil cortadas en 2020 y las de Saber 11 en sus años sin publicar, como 2018 y 2021.
Mientras se renderiza: describe un clúster con dos características que no sean las dos de cobertura, y luego revisa si su nombre dice lo mismo.
Una buena respuesta, a partir de la Figura 21.1: el clúster 4, “Rural, baja cobertura, agua de riesgo alto”, se destaca en cobertura de acueducto (−1.3 DE) y pobreza (+1.0 DE). Su nombre lleva la cobertura pero no la pobreza, una razón más para publicar el perfil al lado del nombre.
21.7 Exploraciones en 3-D (opcional)
La presentación del taller de la que salió este libro tiene cinco vistas 3-D más de las variables de resultado que el agrupamiento nunca usó, por clúster y año: la deserción como terreno, los clústeres como envolventes, los años apilados, los clústeres como órbitas y la deserción en columnas de Voronoi. Son imágenes exploratorias más que evidencia, y corren en vivo en las diapositivas publicadas, en inglés, empezando por la deserción como terreno.
Resumen
- El perfil de un clúster, su puntaje z medio en cada característica, lo describe como una combinación de rasgos que ninguna variable sola habría podido encontrar.
- Una regla escrita le pone nombre a cada clúster a partir de su perfil (entorno, cobertura relativa, nivel de la mediana del IRCA), así que cualquiera puede revisar el nombre.
- “Baja cobertura” es relativa y la palabra del riesgo describe una mediana: la zona rural de Tunja, nunca sin riesgo dentro de la ventana, queda en un clúster que se llama “agua sin riesgo”, llevada ahí por lo que comparte con su zona urbana.
- Las variables de resultado, que nunca se usaron para formar los clústeres, difieren entre los tipos menos que las características, en parte por diseño, y sus distribuciones se superponen.
- La mortalidad infantil registrada más alta no está donde el agua es peor, y los lugares pequeños y las tasas vacías hacen frágil ese orden.
- Todo esto es descripción: una brecha entre tipos no es un efecto de la calidad del agua.
Aun así, una descripción como esta invita a una lectura causal. El Capítulo 22 pone a prueba el vínculo dentro de cada tipo de lugar, donde la pobreza, lo rural y la cobertura se parecen más que en todo el país.
Lecturas adicionales
examples/water/scripts/analysis.py,name_rule(),profiles()youtcomes_by_year(), en el repositorio.examples/water/data/README.md, advertencia 8, sobre por qué la mortalidad infantil se compara solo en 2017–2019 y 2021–2023.- matplotlib, boxplot: lo que muestran las cajas, los bigotes y las medias (consultado el 2026-11-12).