20 Encontrar tipos de lugares: k-means
Quarto, publicación reproducible, agentes de programación, Markdown, Python, EPUB, análisis de datos, k-means
Los datos del agua tienen ahora 11,235 filas preparadas, cada una descrita por nueve puntajes z. Nadie puede leer tantas filas. El agrupamiento las convierte en unos pocos tipos a los que una persona puede ponerles nombre, comparar y sobre los que puede actuar: estas zonas municipales se parecen entre sí, y no se parecen a aquellas. Un funcionario puede preguntar qué tipos necesitan qué ayuda; un concejo puede ver a qué tipo pertenecen sus propias zonas. El agrupamiento no necesita etiquetas, así que es una primera mirada a datos que nadie ha clasificado, y un clúster raro puede señalar un error en los datos o un caso especial. Lo que no puede hacer es explicar: los clústeres describen, no muestran causas.
Si las matemáticas te intimidan, no tienen por qué. El algoritmo es lo bastante simple como para verlo paso a paso, y el criterio que necesita, cuántos tipos buscar, es una decisión que puedes escribir y revisar antes de ver la respuesta.
- Describir el ciclo de k-means, y por qué necesita muchos inicios y una semilla fija.
- Aplicar la regla escrita para k, y decir qué tan ajustada fue la decisión.
- Interpretar una silueta baja, una comprobación de estabilidad y una imagen de PCA sin leer de más.
- Ejecutar el paso de agrupamiento y revisar la explicación del agente sobre k.
20.1 k-means en cuatro pasos
k-means necesita un número de entrada: \(k\), cuántos clústeres encontrar. Hace un inicio y luego repite dos movimientos hasta que no cambian nada:
- Coloca \(k\) centros en \(k\) puntos de los datos elegidos al azar.
- Asigna cada punto a su centro más cercano.
- Mueve cada centro a la media de los puntos que tiene asignados.
- Repite 2 y 3 hasta que nada cambie.
Ninguno de los dos movimientos sube nunca la inercia, la suma de las distancias al cuadrado de cada punto a su centro,
\[\text{inercia} = \sum_{i} \lVert x_i - c_{\ell(i)} \rVert^2 ,\]
donde \(x_i\) es el punto \(i\) (en los datos del agua, los nueve puntajes z de una fila), \(c_{\ell(i)}\) es el centro al que está asignado y \(\lVert x_i - c_{\ell(i)} \rVert\) es la distancia en línea recta entre ellos (Sección 19.3). Sobre puntajes z, la inercia está en desviaciones estándar al cuadrado, una unidad sin significado cotidiano, así que solo importan sus cambios. Hay solo una cantidad finita de formas de agrupar los puntos, así que el algoritmo siempre se detiene. No siempre se detiene en la mejor respuesta: un mal inicio puede atraparlo en un agrupamiento peor. La Figura 20.1 muestra el algoritmo sobre 560 puntos sintéticos en tres grupos, datos de juguete inventados para la ilustración, no los datos del agua.
Esta vista 3-D necesita WebGL. Los cuatro pasos se enumeran arriba.
1. coloca 3 centros en puntos al azar
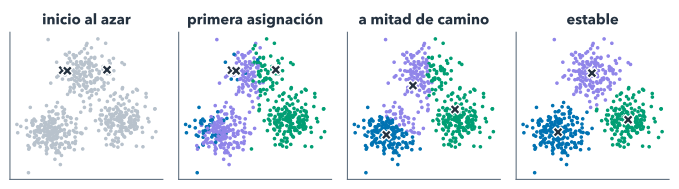
Inicios distintos pueden terminar en agrupamientos distintos, así que el análisis real ejecuta k-means desde 20 inicios (el n_init de scikit-learn) y se queda con el de menor inercia. Los inicios son aleatorios, pero repetibles: una semilla aleatoria fija, el número que pone en marcha el generador de números aleatorios de la computadora, los hace iguales en cada ejecución, así que tu proyecto, las diapositivas del taller y este libro obtienen los mismos clústeres.
Los inicios reales no se colocan al azar, como en el juguete. El método por defecto de scikit-learn, k-means++ (Arthur y Vassilvitskii, 2007), elige el primer centro al azar entre los datos y cada uno de los siguientes con una probabilidad proporcional a su distancia al cuadrado del centro más cercano ya elegido. Eso dispersa los centros y hace menos probable un inicio atascado; scikit-learn usa una variante voraz que saca varios candidatos en cada paso y se queda con el mejor.
20.2 Elegir k
k es un hiperparámetro: una opción que el algoritmo no puede aprender de su propio objetivo, porque la inercia siempre baja a medida que k crece, hasta cero cuando cada punto es su propio clúster. Así que el análisis ajusta k-means para k de 2 a 8 y lee dos medidas (Figura 20.3). La primera es dónde la inercia deja de bajar mucho, el codo. La segunda, la silueta, puntúa de −1 a 1 cuánto más cerca está cada punto de su propio clúster que del siguiente, promediado sobre los puntos. Necesita todas las distancias entre puntos, así que se calcula sobre una muestra fija de 5,000 filas, lo que la mantiene rápida.
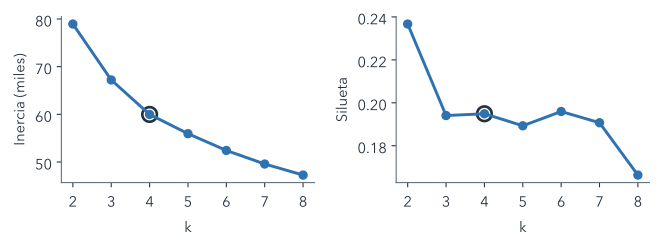
La regla, escrita en choose_k() en el script del análisis, tiene tres partes, y la Tabla 20.1 la aplica fila por fila:
- Se excluye k = 2. Dos clústeres separan sobre todo las filas urbanas de las rurales, cosa que ya sabíamos: coinciden con la zona en el 86% de las filas. El script lo mide con el índice de Rand ajustado (ARI), que puntúa cuánto coinciden dos agrupamientos más allá de lo que daría el azar: 1 significa idénticos, 0 no mejor que el azar. Aquí es 0.50.
- El codo: toma el k más pequeño, de 3 en adelante, después del cual un clúster más recorta la inercia en menos de un 10%. Aquí es k = 4: un quinto clúster recorta la inercia solo un 7%.
- La comprobación de la silueta: la silueta de k debe estar a menos de 0.01 de la mejor para k ≥ 3. En k = 4 es 0.195. La comprobación aquí solo descarta k = 8.
choose_k(), fila por fila, sobre las filas conservadas: cuánto recortaría la inercia un clúster más, la silueta (sobre la muestra fija) y el veredicto. Calculado por el analysis.py del proyecto terminado.
| k | Un clúster más recorta | Silueta | Veredicto |
|---|---|---|---|
| 2 | 14.9% | 0.237 | excluido: la separación urbana–rural |
| 3 | 10.8% | 0.194 | uno más todavía recorta un 10% o más |
| 4 | 6.7% | 0.195 | elegido: el más pequeño que pasa |
| 5 | 6.3% | 0.189 | pasa, pero es más grande |
| 6 | 5.4% | 0.196 | pasa, pero es más grande |
| 7 | 4.7% | 0.191 | pasa, pero es más grande |
| 8 | – | 0.166 | silueta demasiado por debajo de la mejor |
El codo es ajustado. El cuarto clúster en sí recorta la inercia un 10.8% (la fila de k = 3), apenas por encima del umbral del 10%, así que un umbral del 11% elegiría k = 3. Y los cuatro clústeres explican el 41% de la dispersión de los datos, uno menos la razón entre su inercia y la de un solo clúster; el resto es diferencia dentro de los tipos.
Después del ajuste vienen dos comprobaciones más. Estabilidad: los reajustes desde 5 semillas distintas coinciden, con un índice de Rand ajustado de al menos 0.998, así que el resultado no depende del inicio. Eso no dice nada sobre otros datos, otras características u otro k; reajustar sobre filas sacadas otra vez al azar (un bootstrap), o dejar fuera un año a la vez, pondría eso a prueba. Orden: los clústeres se numeran según el IRCA de su centro, del más bajo al más alto, así que una nueva ejecución conserva los mismos números y colores.
Una silueta cerca de 0.2 es baja. En la lectura subjetiva que proponen Rousseeuw y sus colegas, una silueta promedio máxima de 0.25 o menos significa que “no se ha encontrado una estructura sustancial” (Struyf, Hubert y Rousseeuw, 1997, Tabla 2; cita traducida), y la mejor aquí, con cualquier k, es 0.24. Los tipos se superponen: resumen un continuo más que separar islas de datos. Así que trata k como una cuestión de criterio, y no fuerces un número de clústeres para contar una historia más bonita. Escribir la regla antes de ver el resultado es lo que mantiene honesta esa elección; choose_k() al menos hace explícita la regla, para que cualquiera pueda revisarla y ver qué tan ajustada fue la decisión.
Un funcionario lee el informe y pregunta: “¿Entonces Colombia tiene cuatro tipos de zona municipal?” ¿Qué le respondes?
Que cuatro es un resumen útil, no un descubrimiento. Una regla escrita lo eligió por un margen estrecho, y un umbral un punto porcentual más alto elige tres; la silueta baja dice que los tipos se superponen. Los clústeres describen combinaciones típicas de agua, servicios y contexto, y una zona cerca del borde de uno podría estar igual de bien en el siguiente.
20.3 Una imagen de los clústeres
Nueve dimensiones no se pueden dibujar. El análisis de componentes principales (PCA) encuentra las direcciones en las que más varían los datos y proyecta las filas sobre ellas. Cada dirección, una componente principal, es una suma ponderada de los nueve puntajes z, y sus pesos, llamados cargas, dicen qué mide. La Figura 20.4 usa las dos primeras componentes, que conservan el 30% y el 21% de la varianza.
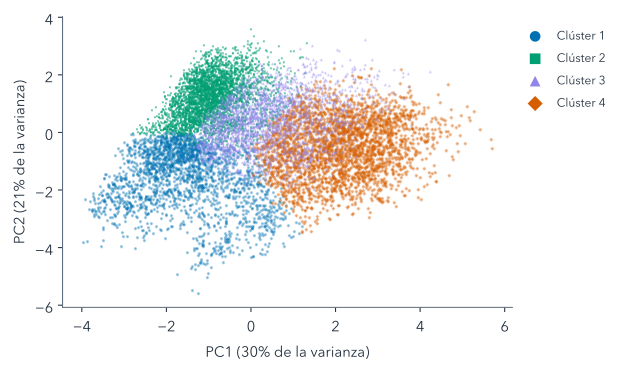
Las superposiciones de la imagen pueden ser separaciones en las dimensiones que deja fuera. Agregar una tercera componente, que conserva otro 16% de la varianza, muestra cuánto (Figura 20.5). En dos componentes, en promedio el 78% de los 15 vecinos más cercanos de una zona-año están en su propio clúster; en tres, el 94%. La tercera componente sube con la altitud y baja con la precipitación, sus dos cargas más grandes. El clúster 3, el más mezclado en dos dimensiones, queda por debajo de los demás a lo largo de ella: es el más bajo y el más lluvioso de los tipos.
Esta vista 3-D necesita WebGL. La imagen 2-D es la figura de arriba.
20.4 Dónde están los clústeres
La altitud lleva la carga más grande de la tercera componente. Un mapa muestra la altitud directamente (Figura 20.6): una columna por cada una de las 966 zonas urbanas agrupadas en 2023, en el centroide de su municipio, tan alta como la altitud de su cabecera (un punto SRTM derivado, exagerado 50 veces) y con el color de su clúster.
Esta vista 3-D necesita WebGL. Mediana de la altitud de las cabeceras, zonas urbanas de 2023: clúster 1: 1,256 m; clúster 2: 1,766 m; clúster 3: 130 m; clúster 4: 159 m.
Las zonas urbanas del clúster 2 son las más altas, con una mediana de altitud de 1,766 m, y el 56% de ellas están en la región Centro Oriente (la agrupación regional del DANE). Las del clúster 3 son las más bajas, a 130 m, y el 53% de ellas están en Caribe. Esto muestra dónde están los tipos, no por qué difieren. La cabecera de Tunja está a 2,695 m, y sus 16 zonas-año, urbanas y rurales, caen todas en el clúster 1.
El mapa dibuja solo zonas urbanas, una columna por municipio, porque la altitud es la de la cabecera. Así que muestra poco del clúster 4, cuyas zonas-año son rurales en un 91%. Sus pocas columnas urbanas son bajas, con una mediana de 159 m, pero la mediana de la altitud de las cabeceras de sus zonas-año rurales es de 1,475 m, así que el mapa dice poco sobre dónde se encuentra ese tipo.
20.5 Usar el modelo, o construirlo
Hay dos rutas para el modelado, y las dos terminan con los mismos outputs/ y las mismas páginas:
- Usarlo (la ruta normal): copia el
analysis.pyterminado desde el punto de control de este paso, ejecútalo y dedica tu esfuerzo a revisar lo que eligió y a las publicaciones. - Construirlo (un desafío): dale al agente el prompt de abajo y haz que escriba él mismo el paso de agrupamiento.
Este es un libro sobre publicar, así que usar el modelo terminado es la ruta normal, no un plan B. Pero un script copiado solo es tan confiable como tu lectura de él, así que la ruta tiene dos prompts: uno ejecuta el script y el otro hace que el agente explique lo que imprimió.
Copia ../quarto-workshop/checkpoints/07-water-cluster/scripts/analysis.py sobre scripts/analysis.py (guarda el mío como scripts/analysis-before-07.py), ejecútalo con `uv run python scripts/analysis.py` y dime cuál es k.copia el script, guardando el tuyo · uv run python scripts/analysis.py · informa k = 4
Entre lo que imprime, el script muestra la tabla detrás de la Figura 20.3 y luego su veredicto en una sola línea, en inglés, que con los datos de este libro dice:
k = 4: the next cluster cuts inertia by only 7% (< 10%), and its silhouette 0.195 is within 0.01 of the best k >= 3 (0.196).
Es decir: con k = 4, el clúster siguiente recorta la inercia solo un 7% (menos del 10%), y su silueta está cerca de la mejor para k ≥ 3. Pídele al agente que desarme esa línea:
Explica lo que imprimió scripts/analysis.py sobre k: qué significan `inertia`, `silhouette`, ari_vs_zone e inertia_drop para cada k, y qué prueba de choose_k() eligió k. Cita las líneas de choose_k() que lo deciden.lee la tabla impresa y choose_k() · explica cada columna y la regla, citando el código
Mientras lo explica: ¿qué prueba de choose_k() eligió k, y cuál solo habría podido descartar uno?
Lo eligió el codo: k = 4 es el k más pequeño, de 3 en adelante, después del cual un clúster más recorta la inercia en menos de un 10%. k = 2 queda excluido antes de cualquier prueba, y la comprobación de la silueta solo veta: aquí solo descarta k = 8. Compara la explicación del agente con esto y con la Tabla 20.1: si dice que la silueta eligió k, leyó mal la regla.
Para construirlo (opcional):
En scripts/analysis.py, ejecuta k-means sobre las características z_ para k=2–8 (random_state=42, n_init=20); guarda la inercia y la silueta en outputs/k_selection.csv; elige k por el codo, revisa la silueta y el ARI con 5 semillas; numera los clústeres según el IRCA del centroide; guarda outputs/clusters.parquet (las columnas preparadas + `cluster`, pc1, pc2). Ejecútalo; explica k.Si lo construyes, tu k puede ser distinto de 4 cuando tu preparación es distinta, y está bien si la razón es sólida. Lo que importa es que la regla para elegir k quede escrita antes de ver la respuesta, y que los clústeres se numeren con una regla fija (aquí, el IRCA del centro, que el prompt llama IRCA del centroide), para que una nueva ejecución conserve los mismos números y colores.
20.6 La página de los clústeres
Las dos rutas construyen luego la segunda página del proyecto, que solo lee outputs/ y nunca vuelve a ajustar:
Crea clusters.qmd, en inglés, que lea outputs/k_selection.csv y outputs/clusters.parquet y muestre un gráfico del codo, la silueta por k y un diagrama de dispersión de PCA (pc1, pc2) coloreado por clúster, cada uno con pie de figura y texto alternativo. Renderízalo y cuéntame si hay errores.escribe clusters.qmd · uv run quarto render clusters.qmd
abres clusters.html en tu navegador
Resumen
- k-means asigna los puntos al centro más cercano y mueve los centros a la media de sus puntos; puede estancarse, así que se queda con el mejor de muchos inicios con semilla.
- k se elige con una regla escrita de antemano: excluir k = 2, tomar el codo, dejar que la silueta vete.
- El codo es ajustado y la silueta, baja: los tipos resumen un continuo.
- La coincidencia entre semillas muestra independencia del inicio, no de los datos ni de las características.
- El PCA y el mapa muestran dónde están los tipos, no por qué, y el mapa deja fuera las zonas-año rurales.
- Usar el modelo terminado es legítimo si puedes explicar lo que eligió.
Por ahora, los tipos son solo números, del clúster 1, el de IRCA del centro más bajo, al clúster 4: el capítulo siguiente averigua qué distingue a cada uno, le pone nombre con una regla y compara las variables de resultado que el agrupamiento nunca vio.
Lecturas adicionales
- scikit-learn, Clustering: k-means y silhouette analysis (consultados el 2026-11-12).
- scikit-learn, Principal component analysis (consultado el 2026-11-12).
- Stuart P. Lloyd, “Least squares quantization in PCM”, IEEE Transactions on Information Theory 28(2), 129–137, 1982, https://doi.org/10.1109/TIT.1982.1056489: el algoritmo detrás de k-means (consultado el 2026-11-12).
- Peter J. Rousseeuw, “Silhouettes: a graphical aid to the interpretation and validation of cluster analysis”, Journal of Computational and Applied Mathematics 20, 53–65, 1987, https://doi.org/10.1016/0377-0427(87)90125-7: la silueta (consultado el 2026-11-12).
- Anja Struyf, Mia Hubert y Peter Rousseeuw, “Clustering in an object-oriented environment”, Journal of Statistical Software 1(4), 1997, https://doi.org/10.18637/jss.v001.i04: la Tabla 2 interpreta el coeficiente de silueta (consultado el 2026-11-12).
- David Arthur y Sergei Vassilvitskii, “k-means++: the advantages of careful seeding”, SODA 2007 (ACM-SIAM Symposium on Discrete Algorithms), https://theory.stanford.edu/~sergei/papers/kMeansPP-soda.pdf (consultado el 2026-11-12).
examples/water/references.biben el repositorio del taller: los artículos sobre k-means, la silueta y el índice de Rand ajustado que cita el documento técnico terminado, revisados contra las páginas de sus editoriales.