17 La pregunta, los datos y las reglas
Quarto, publicación reproducible, agentes de programación, Markdown, Python, EPUB, análisis de datos, k-means
En 2023, el informe nacional de Colombia sobre el agua para consumo humano le dio al agua de sus zonas urbanas un 5.7, en el nivel de riesgo bajo, y al agua de sus zonas rurales un 36.5, en el nivel de riesgo alto (Tabla 17.1). Las proyecciones del DANE ubican a 12.6 millones de personas, el 24% de la población, en zonas rurales en 2023. La gente bebe y cocina con esta agua, así que vale la pena saber dónde está el riesgo y qué lo acompaña.
La pregunta de esta parte es, entonces: ¿qué tipos de zona municipal existen en Colombia, a juzgar por la calidad del agua, los servicios y el contexto, y en qué se diferencian entre ellos los resultados de salud y de educación? Los números de la Parte II eran conteos simples; estos no. Cada paso tiene una forma de salir mal que un renderizado limpio no va a revelar: una variable que significa algo más estrecho que su nombre, un vacío que no es aleatorio, una comparación que parece causal y no lo es.
- Explicar qué mide el IRCA, y por qué el IRCA de esta parte subestima el riesgo.
- Identificar la unidad de análisis, y decir qué significa una celda vacía.
- Distinguir las características de las variables de resultado, y explicar por qué agrupar según una variable de resultado es circular.
- Preparar los datos, las reglas y el entorno del proyecto del agua.
17.1 La pregunta y sus lectores
La pregunta se divide en dos, y el orden importa:
- ¿Qué tipos de zona municipal existen, a juzgar por la calidad del agua, los servicios y el contexto?
- ¿En qué se diferencian los resultados de salud y de educación entre esos tipos?
Los “tipos” van a ser clústeres: grupos de zonas-año, cada una la zona urbana o rural de un municipio en un año (Sección 17.4), que se parecen entre sí en las variables elegidas, encontrados por un algoritmo llamado k-means (Capítulo 20). Como la unidad es una zona en un año, las dos zonas de un municipio pueden pertenecer a tipos distintos, y una zona puede pasar de un tipo a otro con los años.
La respuesta tiene dos lectores. Los funcionarios la van a leer como un informe, en Word o en PDF, y un concejo municipal la va a ver como una presentación corta (Capítulo 23). Los dos van a buscar dónde actuar, y los dos van a tener la tentación de leer una diferencia entre tipos como un efecto del agua. Así que los límites se dicen desde ahora, cada uno con su razón. El puntaje del agua cubre solo los sistemas que opera un prestador (Sección 17.2). Muchas zonas rurales no tienen ningún puntaje, así que los resultados describen los sistemas que se muestrearon (Sección 18.2). Y las comparaciones describen; no pueden establecer que el agua cause ninguna variable de resultado (Capítulo 22).
17.2 Medir el riesgo del agua: el IRCA
Colombia mide la calidad del agua potable con el IRCA, el Índice de Riesgo de la Calidad del Agua para consumo humano, definido en la Resolución 2115 de 2007. Va de 0, todas las pruebas aprobadas, a 100, todas las pruebas reprobadas, y el artículo 15 divide la escala en cinco niveles (Tabla 17.1).
| IRCA | Nivel | Cifras nacionales de 2023 que caen en él |
|---|---|---|
| 0–5 | sin riesgo | |
| 5.1–14 | bajo | zonas urbanas 5.7; prestadores 7.4 |
| 14.1–35 | medio | el país entero 16.4 |
| 35.1–80 | alto | zonas rurales 36.5; autoabastecimiento 43.7 |
| 80.1–100 | inviable sanitariamente |
El promedio nacional cae en el nivel medio y esconde la brecha entre lo urbano y lo rural, y por eso los datos de esta parte mantienen separadas las dos zonas de cada municipio.
Las muestras de vigilancia del agua del grifo se analizan contra límites sanitarios. Cada característica analizada tiene un puntaje de riesgo: Escherichia coli 25, coliformes totales 15, turbiedad 15, cloro residual libre 15, color aparente 6 y pH 1.5, entre otras. El IRCA de una muestra es el puntaje de las características que no cumplen su límite, como porcentaje del puntaje de todas las analizadas, y el IRCA de un mes es la media de sus muestras (artículos 13 y 14). Por eso 0 significa que se aprobaron todas las pruebas y 100, que se reprobaron todas.
El IRCA de los datos de esta parte no es la cifra nacional. La tabla abierta de la que viene (INS, datos.gov.co nxt2-39c3) contiene el IRCA de prestadores: muestras de sistemas que opera un prestador del servicio de agua. Una revisión del 2026-10-30, registrada en el README de los datos (advertencia 1), encontró que sus totales departamentales de 2023 coinciden con la columna de prestadores del INCA en 30 de 30 departamentos, y con la cifra total en solo 5. Los sistemas de autoabastecimiento, que no tienen prestador, puntúan mucho peor (43.7 frente a 7.4 en 2023), así que los datos subestiman el riesgo donde la gente depende del autoabastecimiento, y no dicen nada donde no existe un prestador. Llama a la variable “IRCA de prestadores” en todas partes donde aparezca.
17.3 Saber 11, y lo que cubre un promedio
Una de las variables de resultado que compara el análisis (Sección 17.5) es una medida de educación, Saber 11, el examen nacional que presentan los estudiantes que terminan la educación media, a cargo del ICFES. Tiene cinco pruebas: lectura crítica, matemáticas, sociales y ciudadanas, ciencias naturales e inglés. El puntaje global es cinco veces la media ponderada de los puntajes de las cinco pruebas (cada uno de 0 a 100; inglés cuenta una vez y las demás, tres veces), de 0 a 500, y su media se fijó en 250 en la primera aplicación de 2014, para que los años se puedan comparar (ICFES, Guía de orientación Saber 11.° 2017-1, pp. 101 y 104, consultada el 2026-10-30).
Las dos medidas son promedios, y un promedio describe solo aquello sobre lo que se promedió. El IRCA es un promedio de las muestras de agua tomadas, así que un sistema que nunca se muestrea no tiene ningún IRCA. La media de Saber 11 de los datos es un promedio de los estudiantes que presentaron el examen en colegios de ese municipio y esa zona, así que no dice nada de los estudiantes que habían dejado el colegio. Ten presentes los dos hechos en cada comparación que sigue.
17.4 De dónde vienen los datos
La mayoría de los datos son datos abiertos colombianos de cinco entidades públicas; la precipitación y la altitud vienen de dos conjuntos de datos científicos. Todos se unen por un solo código: unir dos tablas es emparejar sus filas por una columna que comparten, aquí el código que la lista de municipios del DANE, la DIVIPOLA (División Político-Administrativa), le asigna a cada municipio. Tiene cinco dígitos, dos para el departamento y tres para el municipio, así que 05001 es Medellín, en Antioquia (05). Las fuentes son:
- INS (Instituto Nacional de Salud): los resultados de la vigilancia del IRCA.
- DANE (Departamento Administrativo Nacional de Estadística): la lista de municipios y sus códigos, las proyecciones de población y los límites municipales.
- ICFES y MEN (Ministerio de Educación Nacional): los resultados de Saber 11 y las tasas de deserción escolar.
- DNP (Departamento Nacional de Planeación), a través de su portal TerriData: la cobertura de acueducto y de alcantarillado, la pobreza multidimensional, el desempeño municipal, las transferencias para agua y la mortalidad infantil.
- CHIRPS (los datos de precipitación del Climate Hazards Center) y SRTM de la NASA (datos de elevación): la precipitación y una altitud derivada para cada cabecera.
Llegan como tres archivos, en examples/water/data/ del repositorio del taller: water_municipal.csv (la tabla del análisis), municipios.geojson (los límites municipales para los mapas) y README.md, que documenta cada columna, fuente, licencia y advertencia (el Apéndice G las enumera todas).
Una fila es la zona urbana o rural de un municipio en un año, una zona-año: esta es la unidad de análisis. La zona urbana es la cabecera municipal; la zona rural son los centros poblados más pequeños y el campo disperso. La tabla cubre cada una de las 1,122 entradas de la DIVIPOLA del DANE, las dos zonas y cada año de 2010 a 2023: 31,416 filas y 29 columnas. De esas entradas, 1,103 son municipios; el resto son la isla de San Andrés y áreas que no son municipios, cuyas filas están casi vacías. Como cada municipio tiene todas sus filas, un vacío es una celda vacía, nunca una fila que falta.
La zona rural de un municipio no tiene IRCA en un año. ¿Su agua era segura ese año?
Los datos no pueden decirlo. El IRCA promedia las muestras tomadas de sistemas operados por prestadores, así que una celda vacía significa que no se publicó ningún puntaje de prestadores: puede que la zona no se haya muestreado, o que su agua sea de autoabastecimiento, que a nivel nacional puntúa mucho peor (Tabla 17.1). Un IRCA vacío es desconocido, nunca seguro y nunca cero.
Lee data/README.md antes de analizar nada, y pídele al agente que también lo lea primero. Sus advertencias son las trampas del análisis, por escrito: la fuente del IRCA de arriba; las capitales de departamento que no tienen una separación urbana y rural para la cobertura; un índice fiscal cuyo método cambia en 2020; la mortalidad infantil, cuyo método cambia en 2017; Saber 11 solo en algunos años; pesos que no están ajustados por inflación. Cada una aparece en los capítulos que siguen.
17.5 Características y variables de resultado
La decisión de diseño más importante del análisis del agua es qué variables definen los tipos y cuáles solo los describen.
Las características, que ve el agrupamiento, son nueve variables sobre el agua, la gente y el lugar, y el gobierno. Las variables de resultado, que el análisis solo compara, son la mortalidad infantil, el puntaje de Saber 11 y la deserción escolar (Tabla 17.2, Tabla 17.3). Tres características merecen un comentario. El Índice de Pobreza Multidimensional (IPM) es la proporción de las personas de una zona que son pobres en varios aspectos a la vez, según el censo de 2018. La MDM (Medición de Desempeño Municipal) es el puntaje del DNP sobre la gestión y los resultados de un municipio. Y el SGP (Sistema General de Participaciones) es el sistema de transferencias de la Nación a los municipios: la característica es su asignación para agua potable y saneamiento básico, por persona.
Las dos tablas dan el nivel y los años de cada variable, calculados a partir de las filas de los municipios. Una variable de zona difiere entre las filas urbana y rural de un municipio; una municipal es igual en las dos; “un solo valor” se repite todos los años. Los significados, las unidades y las fuentes salen de data/README.md (TerriData es el portal de datos del DNP).
| Variable | Mide (unidad); fuente | Nivel; años |
|---|---|---|
IRCA (irca) |
índice de riesgo del agua, de prestadores (0–100); INS | zona; 2010–2023 |
Acueducto (water_coverage) |
cobertura de acueducto (%); TerriData | zona; 2010–2023 |
Alcantarillado (sewer_coverage) |
cobertura de alcantarillado (%); TerriData | zona; 2010–2023 |
Pobreza (ipm) |
personas en pobreza multidimensional (%); censo de 2018 | zona; un solo valor |
Proporción rural (rural_share) |
proporción rural de la población (0–1); DANE | municipio; 2010–2023 |
Altitud (altitude_m) |
la altura de la cabecera (m); SRTM | municipio; un solo valor |
Precipitación (rainfall_mm) |
lluvia sobre el municipio (mm al año); CHIRPS | municipio; 2010–2023 |
MDM (mdm) |
puntaje de desempeño municipal (0–100); TerriData | municipio; 2016–2023 |
SGP (sgp_water_pc) |
transferencias para agua (pesos corrientes por persona, en logaritmo); TerriData, DANE | municipio; 2010–2023 |
| Variable | Mide (unidad); fuente | Nivel; años |
|---|---|---|
Mortalidad infantil (infant_mortality) |
muertes de menores de un año por cada 1,000 nacidos vivos; TerriData | municipio; 2010–2023 |
Saber 11 (saber11_mean) |
puntaje medio del examen en los colegios de la zona (0–500); ICFES | zona; 2014–2017, 2019, 2020 y 2022 |
Deserción escolar (dropout_rate) |
estudiantes de colegios públicos que se retiran durante el año (%); MEN | municipio; 2011–2023 |
La última columna importa en cada capítulo que sigue. Una variable de zona se mide por separado para las zonas urbana y rural de un municipio; una municipal es un solo valor para todo el municipio, repetido en sus dos filas. Cinco de las nueve características son municipales, así que las dos filas de un municipio en un año difieren solo en las otras cuatro. Y una variable de resultado municipal, como la mortalidad infantil, debe contarse una vez por municipio, no una vez por fila.
Nunca agrupes según una variable de resultado. Si la mortalidad infantil ayudara a definir los tipos, los tipos diferirían en mortalidad infantil por construcción, y la comparación de la segunda pregunta sería circular: encontraría exactamente lo que se puso. Dejar las variables de resultado fuera del agrupamiento es lo que permite que la comparación diga algo.
Alguien de tu equipo quiere agregar la mortalidad infantil a las características, “ya que es lo que nos importa”. ¿Qué mostraría entonces la comparación de las variables de resultado entre los tipos?
Que los tipos difieren en mortalidad infantil, lo que sería cierto por construcción: el algoritmo habría agrupado las zonas en parte según ese mismo número. La comparación encontraría lo que se puso. La mortalidad infantil sigue siendo una variable de resultado, que solo se compara después de encontrar los tipos.
El mismo cuidado explica por qué el índice fiscal idf no es una característica, aunque describe el gobierno municipal: su método cambia en 2020 (idf hasta 2020, idf_new desde 2020, en escalas distintas), así que no puede formar una sola serie a lo largo de los años que usa el análisis. Una variable que cambia de significado a mitad de camino crearía tipos que son artefactos del cambio.
17.6 Calcular una vez, publicar muchas
La Parte II calculaba en cada página. El análisis del agua calcula una vez (Figura 17.1). Un solo script importable, scripts/analysis.py, hace todo el cálculo y escribe sus resultados en outputs/; cada página solo lee esos resultados y los dibuja. Una decisión de diseño, como cuántas filas descartar por valores faltantes, se toma en un solo lugar, y cada salida la sigue en el siguiente renderizado.
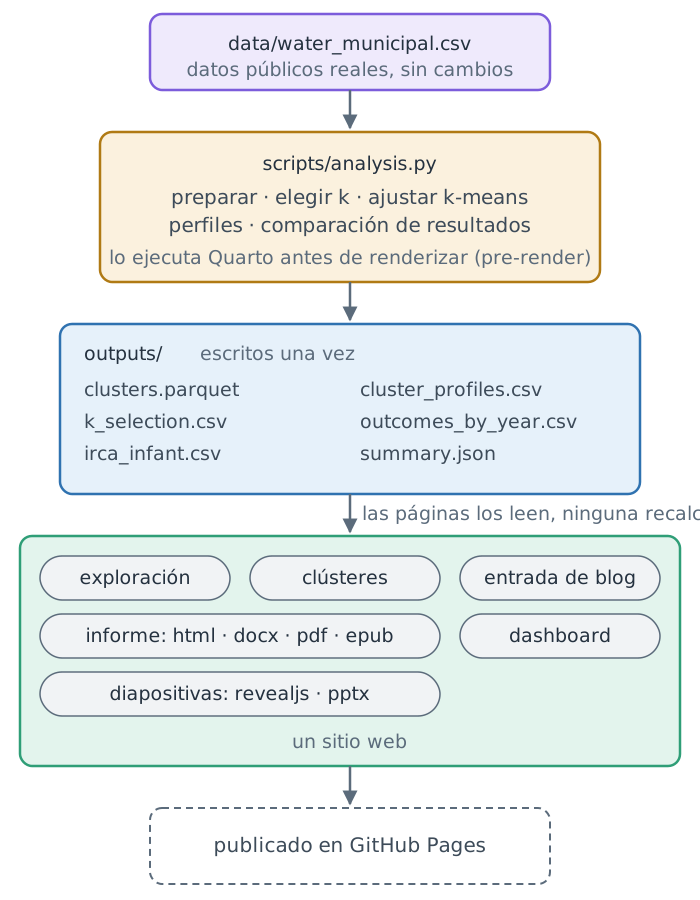
La separación resuelve dos problemas de la Parte II. Un cálculo lento ya no hace lenta cada página ni cada formato, porque se ejecuta una vez. Y ninguna página puede contradecir a otra, porque hay un solo resultado. Los resultados se guardan como Parquet, que conserva los tipos de las columnas (un código como 05001 sigue siendo texto en lugar de convertirse en el número 5001), y como CSV donde la gente los va a abrir.
Este libro sigue la misma regla: cada número del análisis del agua se calcula cuando se construye el libro, importando el analysis.py del proyecto terminado y ejecutándolo en memoria.
17.7 Preparar el proyecto: datos, reglas y entorno
El proyecto vive al lado del de Londres, para que los puntos de control del repositorio del taller estén siempre en ../quarto-workshop/checkpoints/:
~
├── quarto-workshop/
├── london-guide/
└── water-quality/
En tu carpeta personal (~), quarto-workshop/ es el clon del Capítulo 4, london-guide/ es el proyecto de la Parte II y water-quality/ es el de esta parte.
Primero sal del agente de la guía de Londres (/exit), para que el nuevo arranque en la carpeta nueva y la tome como su mundo (Sección 2.4). Luego crea la carpeta, inicia su historial como hiciste con la guía (Sección 6.2), inicia el agente en ella y copia los datos:
cd ~
mkdir -p water-quality
cd water-quality
git init -b main
claudeCopia ../quarto-workshop/examples/water/data en esta carpeta como data/, y luego enumera los archivos de data/ con sus tamaños.copia la carpeta · enumera README.md, municipios.geojson y water_municipal.csv con sus tamaños
Los datos están fuera de la carpeta nueva, en ../quarto-workshop/, así que el agente pregunta antes de leer ahí: apruébalo, como con la guía de Londres (Sección 6.2).
Luego escribe las reglas. Si nunca agrupaste nada, la preocupación es justa: el agente puede escribir un análisis que se ejecuta, se renderiza y está equivocado. No te proteges de eso escribiendo tú el código. Te proteges revisando, y una revisión necesita algo contra lo cual revisar.
Lee data/README.md y luego crea AGENTS.md para este proyecto, en inglés. Alcance: describir la calidad del agua municipal y la mortalidad infantil en Colombia solo a partir de data/. Reglas: deja data/ sin cambios, llama al IRCA IRCA de prestadores (utility-supplied, prestadores), nunca agrupes según variables de resultado, y di que las comparaciones son descriptivas, no causales. Muéstrame el archivo.lee data/README.md · escribe AGENTS.md: alcance, reglas, las advertencias de los datos
apruebas · compruebas que AGENTS.md tenga las cuatro reglas
Las cuatro reglas son este capítulo en miniatura: las entradas son evidencia y quedan sin cambios; el IRCA se llama por lo que es; las variables de resultado describen los clústeres, pero nunca los definen; y las comparaciones entre clústeres no establecen efectos causales de la calidad del agua. Pedirle al agente que lea primero el README le permite agregar por su cuenta las advertencias de los datos a las reglas.
Dale a este proyecto su propio entorno de Python con `uv`: ejecuta `uv init --bare` y luego `uv add ipykernel nbclient nbformat pyyaml pandas numpy matplotlib plotly scikit-learn pyarrow itables tabulate`. Ejecuta `quarto` y `python` a través de `uv run`, y agrega esa regla a AGENTS.md. Crea un .gitignore para .venv/, .quarto/, _site/, outputs/ y *_files/. Muéstrame la línea de Python de `uv run quarto check jupyter`.uv init --bare · uv add … · escribe pyproject.toml, uv.lock y .venv/ · agrega la regla de uv run a AGENTS.md · escribe .gitignore · uv run quarto check jupyter
Deberías ver un Python cuya ruta pasa por el .venv de esta carpeta, como con la guía de Londres (Sección 6.10). La receta es la de la guía de Londres, con los paquetes del análisis agregados: scikit-learn para k-means, pyarrow para Parquet, itables para la tabla con búsqueda del dashboard y tabulate para las tablas escritas como Markdown. Los paquetes que comparte con la Parte II vienen del caché de uv.
Resumen
- Primero, encontrar tipos de zona municipal a partir del agua, los servicios y el contexto; luego, comparar las variables de resultado entre ellos.
- El IRCA de los datos es de prestadores, así que subestima el riesgo donde la gente depende del autoabastecimiento.
- Una fila es una zona-año y todas las filas existen, así que una celda vacía significa que no se midió, nunca que es segura.
- Las variables de zona difieren entre las dos filas de un municipio; las municipales se cuentan una vez.
- Las características definen los tipos y las variables de resultado solo los describen: agrupar según una variable de resultado es circular.
- Un solo script calcula cada resultado una vez, y
AGENTS.mdguarda los límites para el agente.
Lo que las reglas no pueden decir es lo que contiene la tabla: dónde está vacía, y dónde una serie se mueve por razones que no tienen que ver con el agua. Esa es la pregunta del capítulo siguiente.
Lecturas adicionales
- Ministerio de la Protección Social y MAVDT, Resolución 2115 de 2007 (consultada el 2026-10-30).
- MinSalud, MinVivienda, INS y Superservicios, Informe Nacional de Calidad del Agua para Consumo Humano INCA 2023 (consultado el 2026-10-30).
- ICFES, Guía de orientación Saber 11.° 2017-1 (consultada el 2026-10-30).
- datos.gov.co y TerriData del DNP, los portales de las fuentes; cada tabla, licencia y fecha de corte está en
examples/water/data/README.mdy en el Apéndice G. - Quarto, project scripts: ejecutar un script antes de cada renderizado (consultado el 2026-10-30).