Durante la sesión en vivo: sigue el bloque esencial continuo del cuaderno. Las etiquetas de abajo distinguen lo que practicas hoy del material de consulta que puedes explorar después.
Esta es una traducción automática. El original en inglés, Tensors for Machine Learning, es la fuente de verdad: ninguna persona ha revisado frase por frase esta versión. El código, los nombres de funciones y los comentarios # TODO se han dejado en inglés a propósito, porque son exactamente lo que vas a escribir en el cuaderno. Si una frase de aquí contradice al inglés, gana el inglés.
Este es el texto de la sesión: la teoría, todos los ejercicios, las soluciones comentadas y los apéndices para casa. Es lo que hay que seguir durante el taller y lo que conservas después. Los libros y artículos que hay detrás están en la página de referencias, que los guarda para los dos idiomas.
Antes de venir, trabaja los requisitos previos de la página principal del taller: la lectura obligatoria, los cuadernos de trabajo previo y qué tener a mano el día del taller. La página principal es también donde se describe cada uno de los demás recursos: las diapositivas, los cuadernos en los que escribes, los tres controles de Kahoot y las referencias.
Una nota sobre la numeración. Este manual agrupa el taller en cuatro Partes y siete Bloques de ejercicios. En todos los demás sitios —los cuadernos, las diapositivas, las tablas de secciones— los mismos segmentos se numeran del 00 al 12, y ese número es el canónico. La agenda de abajo lleva los dos, así que cualquier fila se puede leer de lado a lado para convertir una etiqueta en la otra.
Practica hoy: Nombrar ejes posibles y predecir un corte en el diagnóstico inicial.
Explora después: Después del diagnóstico, repasar ejemplos de calidad de datos. Completar la preparación antes de clase.
Agenda
| # | Parte | Bloque | Segmento | Formato | Min | Inicio |
|---|---|---|---|---|---|---|
| 00 | — | — | Preparación y bienvenida | preparación | 5 | 00:00 |
| 01 | I | — | Qué es un tensor | demostración | 20 | 00:05 |
| 02 | II | — | Pensar en N dimensiones | demostración | 20 | 00:25 |
| 03 | III | 1 | Indexación y broadcasting con datos reales | ejercicio | 15 | 00:45 |
| 04 | III | 2 | Reshape y transposición de imágenes reales | ejercicio | 15 | 01:00 |
| — | 🎯 | — | Kahoot 1 — Vocabulario de tensores y formas | quiz | 5 | 01:15 |
| — | — | — | Pausa | — | 5 | 01:20 |
| 05 | III | — | Diseño de un pipeline de vídeo | grupo | 15 | 01:25 |
| 06 | IV | 3 | Contracción con einsum | ejercicio | 15 | 01:40 |
| — | — | — | Pausa | — | 5 | 01:55 |
| 07 | IV | 4 | Inversas y la pseudoinversa | ejercicio | 15 | 02:00 |
| — | 🎯 | — | Kahoot 2 — Einsum, distancia y la pseudoinversa | quiz | 5 | 02:15 |
| 08 | IV | — | Recursión con matrices y vectores | demostración | 10 | 02:20 |
| 09 | IV | 5 | Factorizaciones matriciales | ejercicio | 15 | 02:30 |
| — | — | — | Pausa | — | 5 | 02:45 |
| 10 | IV | 6 | Descomposición de Tucker con datos reales | ejercicio | 15 | 02:50 |
| — | 🎯 | — | Kahoot 3 — Convolución y descomposiciones tensoriales | quiz | 5 | 03:05 |
| 11 | IV | 7 | Factorizaciones tensoriales | ejercicio | 15 | 03:10 |
| 12 | — | — | Cierre y ejercicios para casa | cierre | 5 | 03:25 |
Por qué los cuestionarios están donde están. Cada uno va detrás de las secciones que le dan contenido, mientras el material sigue fresco. Cada uno cae también antes del siguiente cambio de contexto: una pausa, o una Parte nueva. Así el cuestionario refuerza el trabajo en vez de interrumpirlo. El cuestionario 1 cierra el trabajo de formas y vocabulario de las secciones 03 y 04. El 2 cierra el tramo de einsum y pseudoinversa, secciones 06 y 07. El 3 cierra el Tucker de la sección 10 mientras el resultado de los taxis sigue en pantalla, antes de que la sección 11 lleve el mismo tensor a CP.
Los datos que usamos
Incluidos dentro de las bibliotecas (sin descarga, funcionan sin conexión):
| Conjunto de datos | Qué es | Forma |
|---|---|---|
load_breast_cancer() |
569 pacientes reales, 30 medidas tomadas de imágenes de células tumorales | (569, 30) |
load_digits() |
1797 dígitos manuscritos reales | (1797, 8, 8) |
data.camera(), data.astronaut() |
Fotografías reales | (512, 512), (512, 512, 3) |
data.immunohistochemistry(), data.cell() |
Imágenes reales de histología y microscopía | (512, 512, 3), (660, 550) |
Se descargan una vez (necesitan internet, tardan unos segundos):
| Conjunto de datos | Qué es | Para qué se usa |
|---|---|---|
| California Housing | 20 640 distritos residenciales reales del censo de EE. UU. de 1990 | Pseudoinversa, mínimos cuadrados |
| NYC Taxi Trips | 6433 viajes reales en taxi por Nueva York | Factorización tensorial |
| Airline Passengers | 144 meses de tráfico aéreo real, 1949–1960 | Recursión, pronóstico |
Todos los fragmentos de código de este manual dan por supuestos los nombres que liga la celda de preparación del cuaderno 00. Si estás leyendo fuera de un cuaderno, empieza aquí:
import numpy as np
import pandas as pd
from sklearn.datasets import load_digits, load_breast_cancer
from skimage import data
from scipy import signal
from scipy.linalg import lu, toeplitz

HOUSING = "https://raw.githubusercontent.com/ageron/handson-ml2/master/datasets/housing/housing.csv"
TAXIS   = "https://raw.githubusercontent.com/mwaskom/seaborn-data/master/taxis.csv"
FLIGHTS = "https://raw.githubusercontent.com/mwaskom/seaborn-data/master/flights.csv"
El cuaderno 00 descarga los tres e imprime sus formas — (20640, 10) (6433, 14) (144, 3). Ejecútalo en Colab antes de la sesión. Si falla, dilo en Discord enseguida: una descarga que falla en silencio te deja atascado en las secciones 07 y 10, una hora después. Todos los demás cuadernos cargan solo los datos que necesita su propia sección, así que puedes abrir cualquiera de ellos en frío.
PARTE I — Qué es un tensor (sección 01, 20 min)
Practica hoy: Nombrar los ejes de imágenes y distinguir forma, orden y número de elementos.
Explora después: Extraer cortes y fibras, y desplegar imágenes como matrices.
1.1 Vocabulario
Ten esta tabla abierta durante todo el taller.
| Término | Significado llano | Inglés | Ejemplo |
|---|---|---|---|
| Tensor | Un array de números con cualquier número de ejes | tensor | Una imagen en color |
| Eje | Una dirección a lo largo de la cual se organizan los datos | axis (pl. axes) | Alto; ancho; color |
| Modo | Otra palabra para eje, usada en teoría de tensores | mode | «desplegado en modo 0» |
| Orden | Cuántos ejes tiene un tensor | order | Una matriz tiene orden 2 |
| Forma | El tamaño de cada eje, como una tupla | shape | (512, 512, 3) |
| Corte | Fijar un índice y dejar el resto | slice | Un canal de color |
| Fibra | Fijar todos los índices menos uno | fiber | Los 3 valores de color de un píxel |
| Desplegado | Reorganizar un tensor en forma de matriz | unfolding | Necesario para las descomposiciones |
| Contracción | Multiplicar y sumar sobre un eje compartido | contraction | El producto escalar |
| Descomposición | Escribir un tensor como producto de otros más simples | decomposition | SVD, PCA, Tucker |
⚠️ Aviso sobre la palabra «rango» (rank). En el capítulo 2, rango es el número de columnas independientes de una matriz. En teoría de tensores, rank suele significar el número de ejes. Para evitar la confusión, este taller dice orden para el número de ejes, y rango solo en el sentido del capítulo 2.
1.2 La forma en NumPy
Todo array de NumPy tiene .shape, una tupla que da el tamaño de cada eje. La longitud de esa tupla es .ndim, el número de ejes.
scalar = np.array(3.0)                     # book: a           — order 0
vector = np.array([1., 2., 3.])            # book: x, x_i      — order 1
matrix = np.array([[1., 2.], [3., 4.]])    # book: A, A_{i,j}  — order 2
tensor = np.random.randn(2, 3, 4)          # book: A_{i,j,k}   — order 3

for name, arr in [("scalar", scalar), ("vector", vector),
                  ("matrix", matrix), ("tensor", tensor)]:
    print(f"{name:8s} shape={str(arr.shape):12s} ndim={arr.ndim}  size={arr.size}")

# scalar   shape=()          ndim=0  size=1
# vector   shape=(3,)        ndim=1  size=3
# matrix   shape=(2, 2)      ndim=2  size=4
# tensor   shape=(2, 3, 4)   ndim=3  size=24
Un escalar tiene shape=(), una tupla vacía: no hay ejes que medir. Y size es siempre el producto de los números de shape: 2 × 3 × 4 = 24.
Ahora con datos reales:
digits = load_digits()
print(digits.images.shape)      # (1797, 8, 8)  — 1797 handwritten digits, 8x8 pixels

photo = data.immunohistochemistry()
print(photo.shape)               # (512, 512, 3) — height, width, colour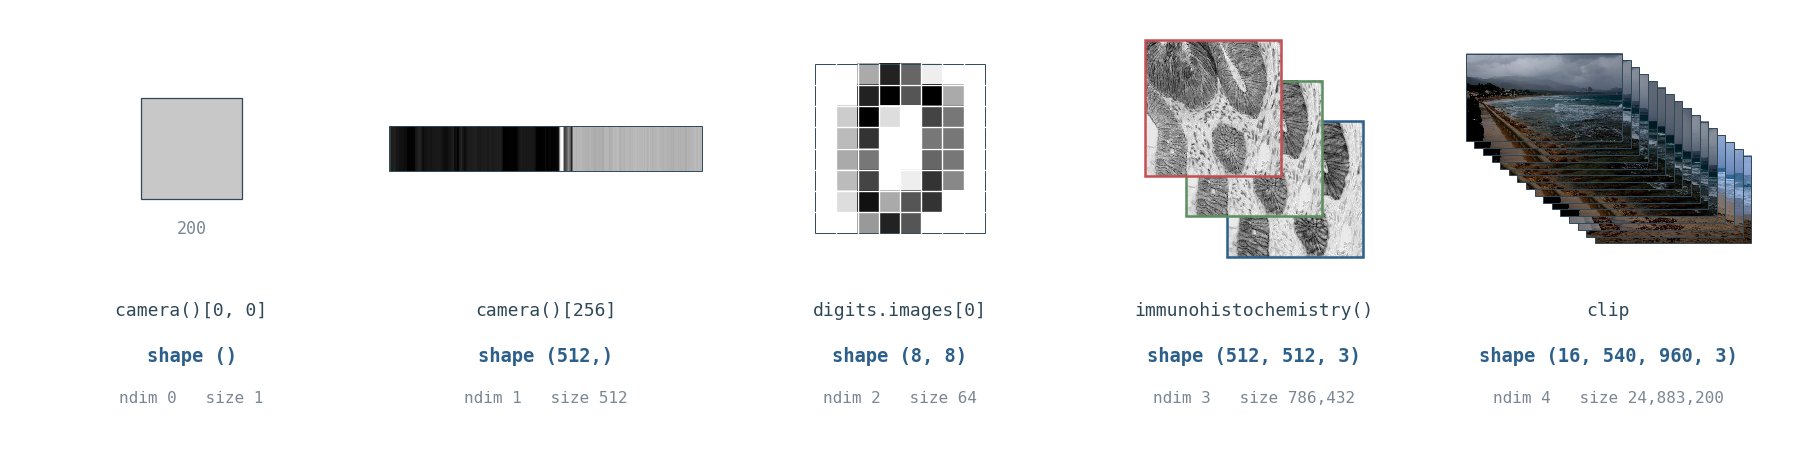
La misma subida, con arrays que vas a encontrar hoy. shape gana un número en cada peldaño; los dos últimos peldaños llevan un 3, y esos dos treses no significan nada parecido.
Los dos son de orden 3, pero sus ejes significan cosas completamente distintas. digits.images cuenta imágenes en el eje 0; photo cuenta colores en el eje 2. La forma por sí sola nunca te dice qué significan los ejes. Tienes que saberlo, y tienes que llevar la cuenta.
1.3 Las tres operaciones que importan
Cortes y fibras: fijar índices desmonta un tensor.
photo[:, :, 0].shape       # (512, 512) — a slice: one colour channel, still an image
photo[100, 200, :].shape # (3,) — a fiber: the 3 colour values of one pixelDesplegado: toda descomposición tensorial empieza convirtiendo el tensor en una matriz, un eje cada vez. Mueve el eje k al frente y luego aplana los ejes restantes en un único eje largo.
def unfold(T, axis):
    return np.moveaxis(T, axis, 0).reshape(T.shape[axis], -1)

print(unfold(photo, 0).shape)   # (512, 1536) — rows are the height axis
print(unfold(photo, 2).shape)   # (3, 262144) — rows are the 3 colour channels
El desplegado no pierde nada. Solo reorganiza. El desplegado en modo 2 dice «cada canal de color es una fila de 262 144 números». Ahora se le puede aplicar cualquier herramienta matricial que conozcas, incluida la SVD.
Contracción: multiplicar a lo largo de un eje compartido y sumar sobre él. El producto escalar (ec. 2.8) y el producto matricial (ec. 2.5) son los dos contracciones. np.einsum las escribe directamente:
a = np.array([1., 2., 3.]); b = np.array([4., 5., 6.])
np.einsum('i,i->', a, b)          # dot product, sum over i          (eq 2.8)

A = np.array([[1., 2.], [3., 4.]]); B = np.array([[5., 6.], [7., 8.]])
np.einsum('ik,kj->ij', A, B)      # matrix product, sum over k       (eq 2.5)
La regla, en una frase: un índice que aparece en las entradas pero no después de la flecha se suma; un índice que aparece después de la flecha se conserva.
1.4 El mapa de las factorizaciones
Una factorización escribe un objeto como producto de objetos más simples. Conociste dos en el capítulo 2. Estas son las ocho que vamos a usar hoy:
| Método | Funciona sobre | Qué te da | Dónde, hoy |
|---|---|---|---|
| LU | Matriz cuadrada | La eliminación gaussiana, guardada para reutilizarla | Abajo |
| QR / Gram-Schmidt | Cualquier matriz | Direcciones perpendiculares y de longitud 1 | Abajo |
| Descomposición espectral | Matriz cuadrada | Direcciones que solo se escalan (§2.7) | Demo de recursión |
| SVD | Cualquier matriz | La factorización matricial más general (§2.8) | Secciones 07 y 10 |
| PCA | Matriz de datos | Compresión a menos variables (§2.12) | Apéndice A |
| Pseudoinversa | Cualquier matriz | La «inversa» cuando no existe una inversa verdadera (§2.9) | Sección 07 |
| Cholesky | Matriz simétrica definida positiva | Una «raíz cuadrada» de una matriz de covarianza, para construir datos correlacionados | Apéndice D |
| Tucker / CP | Tensor, de cualquier orden | PCA generalizado a todos los ejes | Sección 10 |
Hoy se usa cada uno de estos donde hace falta. La sección 09 pone seis factorizaciones lado a lado —cinco de esta tabla, más NMF— y pregunta qué cuesta cada una. Esta tabla no responde a esa pregunta.
A = np.array([[4., 3., 2.], [2., 1., 1.], [6., 3., 5.]])

P, L, U = lu(A)                            # LU: A = P L U
print(np.allclose(P @ L @ U, A))            # True

Q, R = np.linalg.qr(A)                      # QR: orthonormal directions
print(np.allclose(Q.T @ Q, np.eye(3)))      # True — book eq 2.37
LU es la eliminación gaussiana guardada como dos matrices triangulares, de modo que Ax = b se puede resolver barato muchas veces con distintos b. QR (calculada con Gram-Schmidt, o de forma más estable con otros métodos) produce direcciones ortonormales: mutuamente perpendiculares y de longitud 1. Se usa para la inicialización ortogonal de pesos en redes neuronales y para mínimos cuadrados estables.
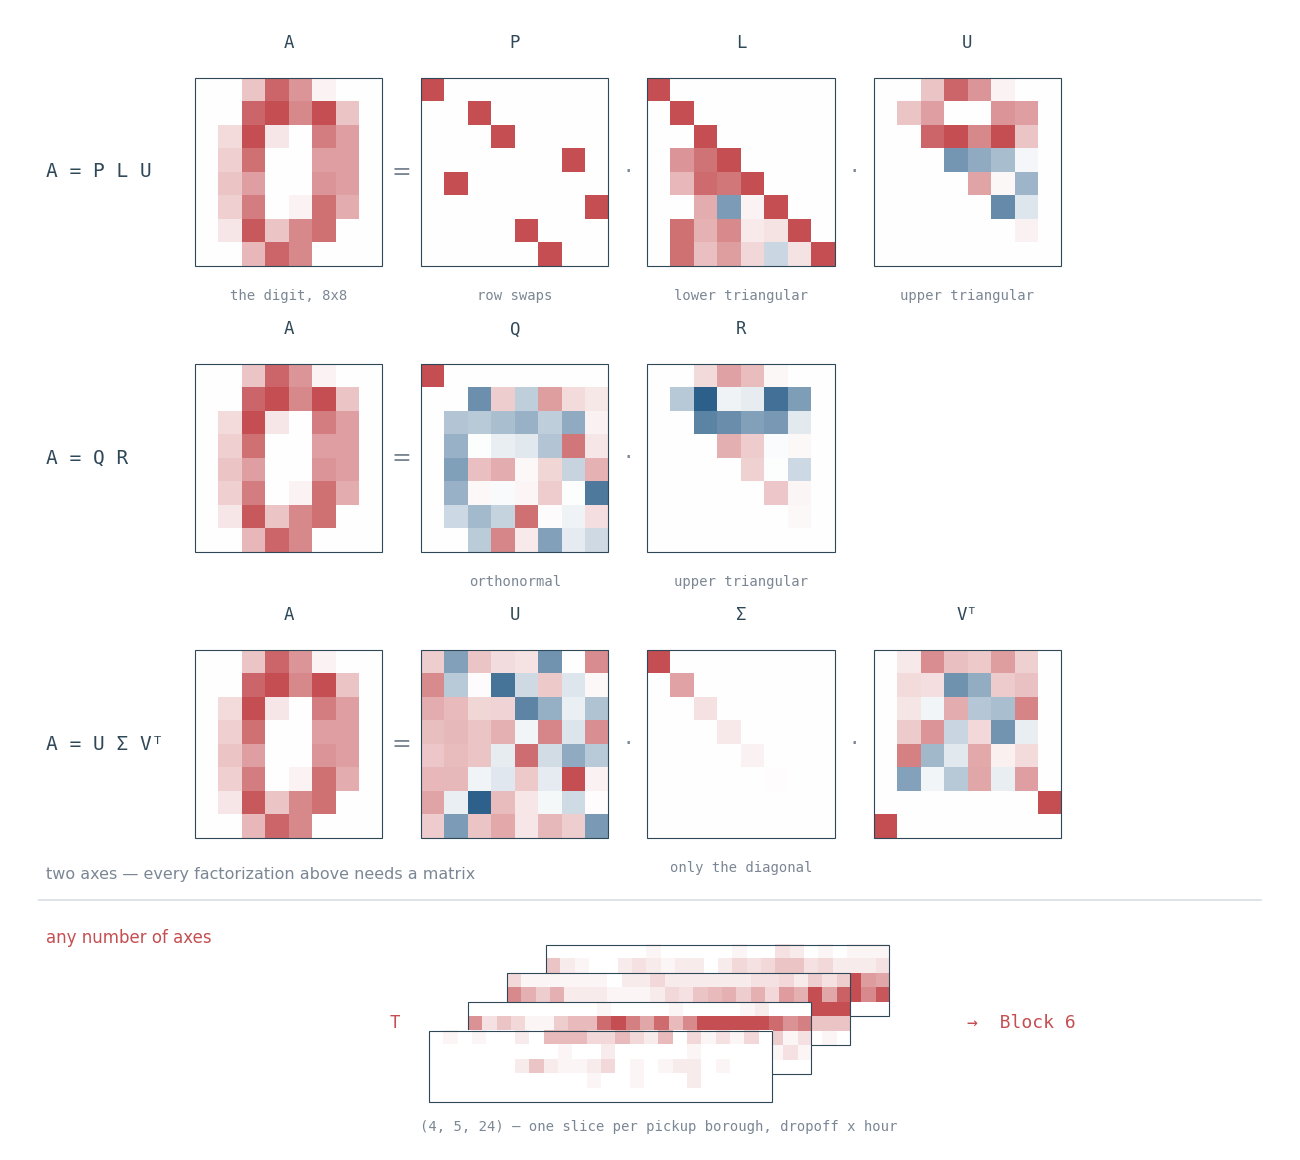
El mismo dígito de 8×8, factorizado de tres formas. Las formas son lo importante: L es de verdad triangular inferior, U superior, y Σ está vacía salvo su diagonal. Debajo de la línea hay un objeto que ninguna de las tres puede tocar.
Cada método de esa tabla por encima de la línea doble funciona sobre matrices: dos ejes. Los datos reales a menudo tienen más. De eso trata la sección 10.
PARTE II — Pensar en N dimensiones (sección 02, 20 min)
Practica hoy: Mantener imágenes y etiquetas emparejadas al barajar; explicar por qué barajar el tiempo cambia una secuencia.
Explora después: Construir lotes de video con relleno e interpretar otros ejes experimentales.
Una demostración de código en vivo en el cuaderno, sobre tensores reales de imagen y de vídeo. Ábrelo en Colab y ejecuta primero la celda de preparación: descarga y comprueba la suma de verificación del clip de vídeo real que usan los ejercicios. Tres ejercicios:
- Leer los ejes en tensores reales.
digits.imageses(1797, 8, 8)y una foto es(512, 512, 3). Los dos son de orden 3, pero el eje 0 cuenta imágenes enteras en uno y filas de píxeles en el otro.digit_batchyvideo_patchson los dos(8, 8, 8). Antes de ejecutar una sola línea de código, di qué cuenta cada eje. - Barajar un lote frente a barajar el tiempo. Barajar el eje 0 es inofensivo para un lote: los ejemplos son independientes, y el orden no lleva información. Destruye un vídeo, donde el orden es la información. La misma operación, un significado completamente distinto. La notación del capítulo 2 no tiene ningún concepto de «el orden entre elementos importa». Eso sí es genuinamente nuevo hoy.
- Agrupar clips de distinta duración. Los vídeos reales tienen distinto número de fotogramas, pero un tensor de lote es rectangular. Toma tres clips reales de longitud 4, 7 y 5 y rellénalos hasta formar un lote de orden 5
(3, 7, 135, 240, 3). Lleva junto a él una máscara booleana(3, 7)de validez, para quevalid.sum() == 16. Así el relleno sigue visible en lugar de promediarse con los datos.
PARTE III — Trabajar con los ejes de un tensor (secciones 03–05)
03 · Indexación y broadcasting con datos reales (Bloque 1, 15 min)
Practica hoy: Predecir formas de broadcasting y estandarizar columnas de píxeles de forma segura si la varianza es cero.
Explora después: Seleccionar observaciones con nombres de características, índices avanzados y máscaras booleanas.
Por qué importa. Los datos de breast_cancer guardan 30 medidas reales de núcleos de células tumorales de 569 pacientes reales. Seleccionar la columna equivocada no produce ningún error: devuelve otra medida real, y tu análisis continúa y da una respuesta segura de sí misma y equivocada. En investigación, eso produce resultados que nadie puede reproducir. En una herramienta clínica, produce una recomendación equivocada sobre una persona real.
En tecnología, la misma operación se ejecuta sobre una matriz (usuarios, artículos) para extraer el historial de un usuario antes de hacerle una recomendación.
Ejercicio (10 min)
bc = load_breast_cancer()
X, y = bc.data, bc.target          # (569, 30); y: 0 = malignant, 1 = benign
names = list(bc.feature_names)

# TODO 1: Print X.shape. Say out loud what each axis means.
# TODO 2: Extract the column "mean radius" for all patients -> shape (569,).
#         Find its position with names.index(...). Do not hard-code a number.
# TODO 3: Find the 5 patients with the LARGEST mean radius, then extract their
#         full 30-measurement profiles as one (5, 30) array, in ONE operation.
# TODO 4: Using boolean indexing, compare mean radius for malignant (y == 0)
#         against benign (y == 1) patients. Is there a real difference?

# --- broadcasting, on real images ---
images = load_digits().images          # (1797, 8, 8)
D = images.reshape(len(images), -1)    # (1797, 64)

# TODO 5: Compute the mean and std of each of the 64 pixels across all images.
# TODO 6: Standardize with broadcasting: (D - mean) / std.
#         RUN IT AND LOOK AT THE RESULT before continuing.
# TODO 7: You will find NaN. How many pixels have std == 0, and why would a real
#         handwritten digit image contain such pixels? Fix it, then verify no NaN.
Explicación (5 min)
i = names.index("mean radius")
radius = X[:, i]                                   # book notation A_{:,j}
top5 = np.argsort(radius)[-5:]
profiles = X[top5, :]                               # (5, 30)
print(radius[y == 0].mean(), radius[y == 1].mean()) # 17.5 vs 12.1

mean, std = D.mean(axis=0), D.std(axis=0)
print((std == 0).sum())                             # 3
Z = (D - mean) / np.where(std == 0, 1.0, std)
Dos resultados reales. Los tumores malignos sí tienen un radio medio mayor: 17,5 frente a 12,1. Y tres píxeles están siempre oscuros en las 1797 imágenes de dígitos: están en esquinas donde nadie escribe. Su desviación típica es exactamente cero, así que dividir produce NaN. Con datos aleatorios nunca habrías visto esto.
La regla de formas tiene su propia página: el simulador de broadcasting alinea dos formas desde la derecha y recorre el estiramiento paso a paso. Prueba (4, 5) contra (4,), y después contra (4, 1).
04 · Reshape y transposición de imágenes reales (Bloque 2, 15 min)
Practica hoy: Convertir HWC a CHW y comprobar que los valores de píxeles conservan su significado.
Explora después: Construir lotes de imágenes, comparar NHWC con NCHW e inspeccionar la disposición en memoria.
Por qué importa. Los microscopios y las cámaras ordenan sus ejes según el hardware, no según lo que espera un modelo. Equivocarse aquí no provoca ningún fallo: el modelo se ejecuta sobre datos revueltos y devuelve una salida segura de sí misma y sin sentido. En un cribado de fármacos, eso es una decisión equivocada sobre si un compuesto funciona. La versión famosa en tecnología: un modelo entrenado en TensorFlow (NHWC) desplegado en PyTorch (NCHW) sin transponer.
Ejercicio (10 min)
photo = data.immunohistochemistry()   # (512, 512, 3) real histology
cells = data.cell()                    # (660, 550)    real microscopy, grayscale

# TODO 1: Print both shapes. Which one has no colour axis?
# TODO 2: Convert `photo` from (H, W, C) to (C, H, W) with np.transpose.
# TODO 3: Stack `photo` three times into a batch of shape (3, 512, 512, 3).
#         Which axis is the batch axis?
# TODO 4: Convert that batch from NHWC to NCHW -> (3, 3, 512, 512).
#         Two axes now both have size 3. How do you know which is which?
# TODO 5: photo.reshape(3, 512, 512) runs WITHOUT error but is wrong.
#         Run it, compare against TODO 2, and explain the difference.
Explicación (5 min)
chw   = np.transpose(photo, (2, 0, 1))      # (3, 512, 512) — correct
batch = np.stack([photo, photo, photo])      # (3, 512, 512, 3)
nchw  = np.transpose(batch, (0, 3, 1, 2))    # (3, 3, 512, 512)
wrong = photo.reshape(3, 512, 512)           # runs, but scrambles the image
reshape solo reinterpreta los números en el orden en que están en memoria. transpose los mueve según el significado de los ejes. Los dos dan la forma (3, 512, 512); solo uno es la imagen. Y el TODO 4 va más al fondo: en cuanto dos ejes comparten tamaño, la forma no puede decirte cuál es cuál. Solo tu propio seguimiento puede.
Las tres fotografías de arriba son cubos, uno por byte, en el visualizador del tensor de imagen. Transpón NHWC a NCHW y observa cómo los cubos siguen la nueva forma mientras la tira del búfer bajo ellos no mueve ni un byte; después compáralo con reshape y mira cómo se rompe la imagen.
Un reshape no trata solo de píxeles. En el escenario del genoma la misma operación agrupa las bases de un gen en codones — de (L, 4) a (L/3, 3, 4), sin coste, porque ya estaban en ese orden — y lo que un codón es entonces resulta ser un 4 × 4 × 4 de rango uno.
Kahoot 1 — Vocabulario de tensores y formas (5 min)
Hazlo antes de la pausa, justo después de la sección 04. La sala acaba de usar orden, eje, forma, varianza, reshape y transposición. Es el momento en que esas palabras están más frescas. Una pregunta pide qué se obtiene al fijar todos los índices menos uno, una fibra, que solo cubre el Explora después de la sección 01. Da la definición en una línea cuando se revele la respuesta. Lanza kahoot_quiz_1_vocabulary_shapes.xlsx (6 preguntas, ~5 min con el podio incluido). No hace falta preparación más allá de haberlo importado a un kahoot con antelación.
Pausa (5 min)
05 · Ejercicio en grupo — Diseño de un pipeline de vídeo (15 min)
Practica hoy: Rastrear fotogramas muestreados hasta sus índices originales y defender un muestreo para un evento breve.
Explora después: Comparar pipelines completos, costes de relleno y organización de cámaras sincronizadas.
La franja en directo es el núcleo del cuaderno 05, no este ejercicio de diseño: una ronda de un minuto de ¿Mito o hecho?, la predicción inicial y el Ejercicio 1 (6 minutos en total), y después la actividad grupal 05, conserva el evento dentro del presupuesto, durante 8 minutos, con sus tres líneas de puesta en común publicadas en Discord. Las cinco preguntas de abajo son la versión para casa del mismo problema. No hay una única respuesta correcta.
Diseña la forma del tensor en cada etapa —archivo bruto → fotogramas decodificados → lote preprocesado → entrada del modelo → salida del modelo— para los dos sistemas: - Tecnología: una app de vídeos cortos que calcula una representación por vídeo a partir de fotogramas muestreados, para elegir qué reproducir a continuación. - Biotecnología: un modelo de vídeo quirúrgico que etiqueta la fase actual de una operación a partir de la cámara del quirófano.
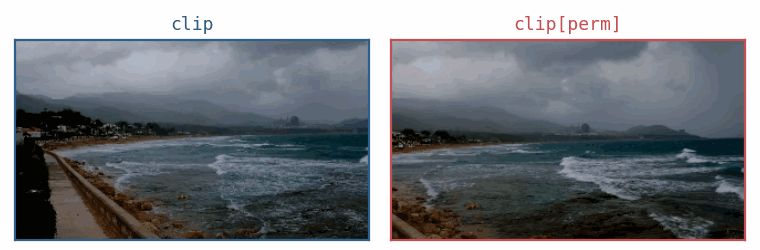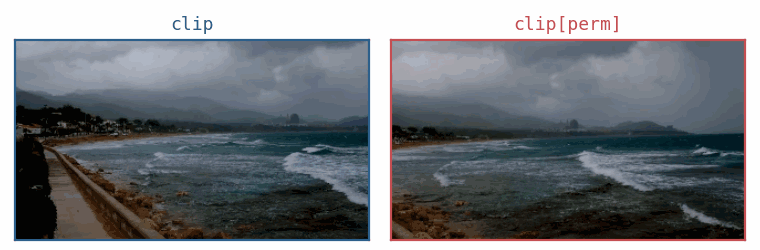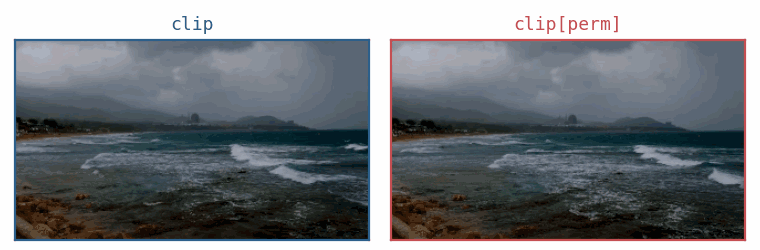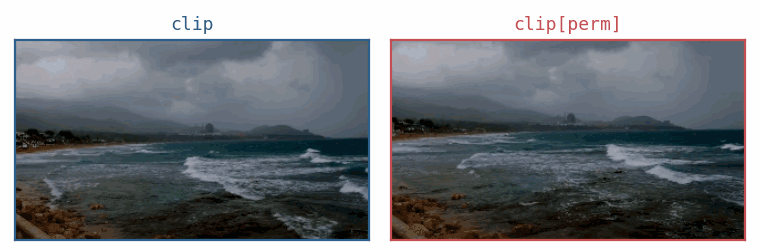
Los dos paneles tienen los mismos ocho fotogramas, la misma forma y la misma suma. Solo cambia el orden del eje 0, y ninguna operación aritmética de este taller puede decirte cuál de los dos es el vídeo.
- Esboza la forma en cada una de las cinco etapas, para los dos. ¿Dónde coinciden y dónde tienen que ser distintas?
- Los clips tienen duraciones distintas: 30 segundos frente a 4 horas. Toma la estrategia de relleno y máscara de la Parte II y da la forma exacta del lote preprocesado. ¿Qué representa un valor inventado o desaprovechado en ese tensor?
- El sistema quirúrgico añade tres ángulos de cámara grabando a la vez. ¿Dónde va ese eje, y por qué su posición cambia lo fácil que es escribir el resto del pipeline?
- El recomendador muestrea 8 fotogramas de 900. ¿Qué operación de la sección 03 hace eso, y qué se pierde?
- Los dos sistemas tienen que decidir qué fotogramas importan más. ¿Qué tipo de mecanismo podría aprender esa ponderación?
PARTE IV — Calcular con tensores (secciones 06–11)
06 · Contracción con einsum (Bloque 3, 15 min)
Practica hoy: Contraer el color con einsum, nombrar los ejes restantes y verificar una suma ponderada de píxeles.
Explora después: Expresar operaciones matriciales con einsum y comparar medidas de similitud de dígitos.
Por qué importa. Los sistemas de recomendación y de búsqueda ordenan los artículos por el producto escalar entre un vector de usuario y todos los vectores de artículo. Eso es un usuario contra millones de artículos, muchas veces por segundo. Esa contracción es la señal de ordenación. Suma sobre el eje equivocado y todos los usuarios reciben resultados erróneos.
Ejercicio (10 min)
photo = data.immunohistochemistry().astype(float)        # (512, 512, 3)
batch = np.stack([photo, data.astronaut().astype(float)]) # (2, 512, 512, 3)
w = np.array([0.2125, 0.7154, 0.0721])                    # RGB -> grayscale weights

# TODO 1: With einsum, convert `photo` to grayscale by contracting the colour
#         axis against w. Result shape (512, 512).
# TODO 2: Do the same for the whole batch in ONE einsum call -> (2, 512, 512).
# TODO 3: Write these Chapter 2 operations as einsum and check each against NumPy:
#           (a) trace          (eq 2.48)
#           (b) transpose      (eq 2.3)
#           (c) matrix product (eq 2.5)
# TODO 4: Flatten the digits to (1797, 64) and compute the (1797, 1797) similarity
#         matrix between every pair of digit images with one einsum.
Explicación (5 min)
gray       = np.einsum('hwc,c->hw',   photo, w)     # (512, 512)
gray_batch = np.einsum('nhwc,c->nhw', batch, w)      # (2, 512, 512)

np.einsum('ii->', A)           # trace          == np.trace(A)
np.einsum('ij->ji', A)         # transpose      == A.T
np.einsum('ik,kj->ij', A, B)   # matrix product == A @ B
c aparece en las entradas pero no después de la flecha, así que se suma: eso es la contracción. n, h y w aparecen después de la flecha, así que se conservan. Añadir un eje de lote cuesta exactamente una letra. Por eso merece la pena aprender einsum. La misma expresión sirve para una imagen o para un millón, y se lee como las matemáticas del capítulo 2. La atención son dos contracciones más de esta misma forma —L = Q Kᵀ suma sobre el eje de características, O = A V suma sobre el eje de claves— en las imágenes de puntuaciones y salida del escenario de atención.
Dos contracciones con datos de secuencia reales hacen el mismo punto en otro alfabeto: el código genético es una tabla de 4 × 4 × 4, así que la traducción es una sola contracción sobre los tres ejes de bases, y buscar en una secuencia es einsum('wlb,lb->w'): el producto escalar de dos filas one-hot es 1 exactamente cuando las bases coinciden, de modo que sumar sobre posición y alfabeto cuenta coincidencias.
La propia multiplicación de matrices es una de estas, con la regla escrita como dato. Los ocho productos de un producto de 2 × 2 son ocho unos en un tensor de 4 × 4 × 4, y contraer ese tensor con las dos matrices es einsum("abc,a,b->c", T, A.ravel(), B.ravel()): dieciséis términos por cada entrada de la respuesta, catorce de ellos multiplicados por cero. La sección 11 vuelve a ese tensor para preguntar en cuántas piezas se parte.
07 · Inversas y la pseudoinversa (Bloque 4, 15 min)
Practica hoy: Mostrar cómo columnas duplicadas dan predicciones idénticas con coeficientes distintos; explicar la elección de norma mínima de pinv.
Explora después: Verificar las cuatro identidades de Moore–Penrose, ajustar datos de vivienda y aplicar pinv a imágenes desplegadas.
Actividad esencial: ¿qué nos dicen los coeficientes?
Usa tres observaciones sintéticas a propósito: x = [1, 2, 3], duplica la característica para formar A = [x, x] y define y = 2*x. Los coeficientes [2, 0] y [0, 2] reproducen y. Cada fila solo depende de la suma de coeficientes, así que estas observaciones no identifican los efectos separados.
Calcula pinv(A) @ y: elige [1, 1]. Todas las soluciones exactas tienen forma [1+t, 1-t], con norma al cuadrado 2 + 2*t**2, mínima en t=0. La norma mínima es una regla matemática de elección; no demuestra efectos reales iguales. Con observaciones ruidosas, pinv elige la solución de menor norma entre las que minimizan el error de mínimos cuadrados.
Intento: construye otro vector de coeficientes con las mismas predicciones, compara normas y explica qué sigue sin conocerse. Sigue el bloque esencial continuo del cuaderno para la retroalimentación y comprobación.
Explora después: la teoría y los ejercicios de vivienda de abajo, incluidas las cuatro identidades de Moore–Penrose, amplían la actividad en vivo.
La teoría, en tres pasos
Paso 1: matrices cuadradas. El §2.3 del capítulo 2 define A⁻¹ para una matriz cuadrada, con A⁻¹A = I. Pero eso solo existe cuando las columnas son linealmente independientes. Una matriz con columnas dependientes es singular y no tiene inversa:
S = np.array([[2., 1.], [1., 3.]])
np.linalg.inv(S) @ S                       # ≈ identity, fine

Singular = np.array([[1., 2.], [2., 4.]])  # column 2 = 2 × column 1
np.linalg.inv(Singular)                     # raises LinAlgError
Paso 2: matrices no cuadradas. A⁻¹ ni siquiera está definida. Pero seguimos necesitando resolver Ax = b. En aprendizaje automático A casi nunca es cuadrada: tiene una fila por ejemplo y una columna por variable, y siempre hay muchos más ejemplos que variables.
La pseudoinversa de Moore-Penrose A⁺ (capítulo 2, §2.9) es la respuesta. Está definida para toda matriz —cuadrada o no, singular o no— y se calcula a partir de la SVD (ec. 2.47):
A = np.random.randn(5, 3)
A_plus = np.linalg.pinv(A)
print(A.shape, A_plus.shape)               # (5, 3) (3, 5) — note the shape flips

U, S_, Vt = np.linalg.svd(A, full_matrices=False)
print(np.allclose(A_plus, Vt.T @ np.diag(1/S_) @ U.T))   # True — this is eq 2.47
Cumple cuatro condiciones que la definen de forma única, todas verificadas como True:
np.allclose(A @ A_plus @ A, A)            # 1
np.allclose(A_plus @ A @ A_plus, A_plus)  # 2
np.allclose((A @ A_plus).T, A @ A_plus)   # 3
np.allclose((A_plus @ A).T, A_plus @ A)   # 4
Lo que te da A⁺ depende de la forma, exactamente como dice el §2.9 del capítulo 2:
- Más filas que columnas (demasiadas ecuaciones, normalmente sin solución exacta) →
x = A⁺bda laxque hace queAxesté lo más cerca posible deb. Esto son los mínimos cuadrados. - Más columnas que filas (muy pocas ecuaciones, infinitas soluciones) →
x = A⁺bda la solución válida de norma más pequeña.
Paso 3: ¿y los tensores? Es una pregunta justa con una respuesta honesta. No hay ninguna inversa tensorial de uso común. Existen varias definiciones —basadas en el producto de Einstein, o en el t-producto para tensores de orden 3— y son investigación activa. En la práctica, en aprendizaje automático, se despliega el tensor en una matriz, se usa la pseudoinversa matricial y se vuelve a plegar el resultado. Eso funciona porque el desplegado no pierde nada:
T = np.random.randn(4, 3, 5)
M = unfold(T, 0)                       # (4, 15)
M_plus = np.linalg.pinv(M)             # (15, 4)
np.allclose(M @ M_plus @ M, M)          # True
Esta es una lección general que merece la pena recordar: cuando un problema tensorial es difícil, despliégalo a una matriz, resuélvelo ahí y vuelve a plegarlo.
Ejercicio (10 min) — datos reales de vivienda en California.
# Predict house value from district features. 20,640 real districts.
print(housing.shape)                                   # (20640, 10)
print(housing['total_bedrooms'].isnull().sum())         # 207 missing values!

# TODO 1: Drop rows with missing values. How many rows remain?
# TODO 2: Build X from these columns, and add a column of ones for the bias:
#         ['housing_median_age','total_rooms','total_bedrooms',
#          'population','households','median_income']
#         Target y = 'median_house_value'. Print X.shape. Is X square?
# TODO 3: Try np.linalg.inv(X). What happens, and why?
# TODO 4: Solve for the weights with the pseudoinverse: w = pinv(X) @ y.
# TODO 5: Check your answer against np.linalg.lstsq. Do they agree?
# TODO 6: Compute the RMSE of the predictions. Which feature has the largest
#         coefficient, and does that make sense for house prices?
Explicación (5 min)
d = housing.dropna()                                     # 20433 rows remain
feats = ['housing_median_age','total_rooms','total_bedrooms',
         'population','households','median_income']
X = np.column_stack([np.ones(len(d)), d[feats].to_numpy(float)])   # (20433, 7)
y = d['median_house_value'].to_numpy(float)

w = np.linalg.pinv(X) @ y
w_lstsq, *_ = np.linalg.lstsq(X, y, rcond=None)
np.allclose(w, w_lstsq)                                   # True

rmse = np.sqrt(((X @ w - y) ** 2).mean())                 # ≈ 75,980
X es de 20 433 × 7 —muy alta—, así que np.linalg.inv ni siquiera se puede llamar. No hay solución exacta: ninguna recta pasa por 20 433 puntos. La pseudoinversa da en su lugar la mejor respuesta posible. lstsq coincide con ella exactamente, porque resuelve el mismo problema. El coeficiente más grande es el de median_income (unos 47 700 por unidad), que es el resultado sensato: la renta predice el precio de la vivienda.
Esa geometría tiene su propia página: el escenario de proyección y SVD toma tres de estos distritos y dos predictores, de modo que el espacio columna es un plano que se puede ver, y dibuja ŷ como el punto más cercano sobre él, con el residuo encontrándolo en ángulo recto. Desliza y fuera del plano y observa cómo β se niega a moverse: los mínimos cuadrados no pueden ver la dirección que están descartando.
Kahoot 2 — Einsum, distancia y la pseudoinversa (5 min)
Hazlo justo después de la sección 07, antes de la demo de recursión. Cubre la contracción (el einsum de la sección 06), la pseudoinversa y las matrices singulares (sección 07), y distancia y similitud. La matriz de similitud entre dígitos del TODO 4 de la sección 06 es el puente natural entre las dos. Lanza kahoot_quiz_2_distance_pseudoinverse.xlsx (6 preguntas, ~5 min).
08 · Recursión con matrices y vectores (10 min — demo)
Practica hoy: Explicar una actualización de estado matricial y relacionar su repetición con una potencia de matriz.
Explora después: Usar iteración de potencias y evaluar pronósticos recursivos del tráfico aéreo.
Recursión significa definir algo en función de sí mismo. Con matrices esto se convierte en: aplicar la misma matriz una y otra vez. Tres ejemplos, cada uno más útil que el anterior.
1. Fibonacci como multiplicación matricial repetida. La regla f(n) = f(n-1) + f(n-2) es una matriz aplicada repetidamente:
F = np.array([[1, 1], [1, 0]])
v = np.array([1, 0])
for _ in range(10):
    v = F @ v
print(v[1])                                  # 55
print(np.linalg.matrix_power(F, 10)[0, 1])   # 55 — same answer, one step
2. Iteración de la potencia: recursión que encuentra un vector propio. Multiplica cualquier vector de partida por A repetidamente, reescalando cada vez. Converge al vector propio de mayor valor propio (capítulo 2, §2.7):
A = np.array([[4., 1.], [2., 3.]])
x = np.random.randn(2); x /= np.linalg.norm(x)
for _ in range(50):
    x = A @ x
    x /= np.linalg.norm(x)

print(x @ A @ x)                    # 5.000000
print(np.linalg.eig(A)[0].max())    # 5.000000 — identical
Así es como PageRank ordena páginas web. Y por eso los vectores propios importan mucho más allá del capítulo 2: la aplicación repetida de una matriz converge a su vector propio dominante. El paso de autovectores del escenario de proyección y SVD dibuja la prueba misma: un campo de flechas bajo A, con las que conservaron su dirección iluminadas.
3. Recursión sobre datos reales: pronóstico del tráfico aéreo. Esto combina la recursión con la pseudoinversa de la sección 07. Ajustamos un modelo que predice cada mes a partir de los 12 anteriores y luego lo aplicamos a su propia salida para pronosticar hacia adelante:
y = flights['passengers'].to_numpy(float)     # 144 real months, 1949–1960
p = 12
rows = np.array([y[i:i+p] for i in range(len(y) - p)])
X = np.column_stack([np.ones(len(rows)), rows])
w = np.linalg.pinv(X) @ y[p:]                  # least squares, exactly as in section 07

history = list(y[-p:])
for _ in range(12):                             # recursion: feed predictions back in
    nxt = w[0] + np.dot(w[1:], history[-p:])
    history.append(nxt)

print(np.round(history[-12:], 1))
# [465.2 429.1 455.1 491.0 527.8 589.4 679.7 661.3 575.3 509.5 438.6 470.7]
El pronóstico reproduce la forma estacional del tráfico aéreo real —bajo en invierno, con pico en verano— porque el modelo la aprendió de 132 ventanas reales de entrenamiento. Esta es exactamente la estructura de una red neuronal recurrente: un estado oculto, actualizado por los mismos pesos en cada paso.
W, U = np.random.randn(4, 4) * 0.5, np.random.randn(4, 3) * 0.5
h = np.zeros(4)
for t in range(6):
    h = np.tanh(W @ h + U @ xs[t])    # same W and U every step — that is the recursion
09 · Factorizaciones matriciales: cuál elegir y qué cuesta (Bloque 5, 15 min)
Practica hoy: Comparar residuos y sensibilidad de coeficientes; seguir coordenadas reducidas hasta la reconstrucción.
Explora después: Medir otras factorizaciones, comprimir imágenes con SVD e inspeccionar factores NMF.
La §1.4 de la Parte I dibujó el mapa. Las secciones 03 a 08 usaron de pasada tres de las factorizaciones que hay en él: LU y QR en la propia §1.4, y la pseudoinversa en la sección 07. Ninguna respondió a las dos preguntas que se hace de verdad quien practica: ¿a cuál echo mano con estos datos, y qué me cuesta? Esta sección responde a las dos. Es también donde la descomposición espectral por fin se nombra, una hora antes de que la sección 10 se apoye en la misma maquinaria. El cuaderno es 09 · Factorizaciones matriciales.
La idea que lo organiza todo es que las seis son optimizaciones con restricciones, y la restricción es lo que da su forma a cada factorización. QR minimiza ‖y − Xβ‖ sujeto a que Q sea ortonormal. La SVD truncada minimiza ‖A − B‖_F sujeto a rank(B) ≤ k, y Eckart–Young–Mirsky demuestra que nada lo hace mejor. NMF minimiza esa misma cantidad sujeta a W, H ≥ 0. Esa restricción extra es forzosamente peor en error, y se elige de todos modos, porque las componentes salen como partes a las que puedes ponerles nombre. Cholesky y LU no optimizan nada en absoluto. Son reescrituras exactas, y su valor está entero aguas abajo, donde una resolución cuesta O(n²) en lugar de O(n³).
La tabla de costes. Recuento de operaciones en coma flotante del término dominante para una factorización densa m × n con m ≥ n, de Trefethen y Bau, Numerical Linear Algebra:
| Método | Operaciones | La pregunta que responde |
|---|---|---|
Cholesky (n × n SDP) |
n³/3 |
Resolver Ax = b muchas veces, con A simétrica definida positiva |
LU (n × n) |
2n³/3 |
Lo mismo, con A solo cuadrada |
QR (m × n) |
2mn² − 2n³/3 |
Mínimos cuadrados, sin formar XᵀX |
Descomposición espectral (n × n sim.) |
≈ 9n³ |
¿A qué converge la aplicación repetida? |
SVD delgada (m × n) |
2mn² + 11n³ |
La mejor aproximación de rango k de cualquier cosa |
SVD aleatorizada (rango k) |
≈ 4mnk |
Lo mismo, cuando k ≪ n y A es densa |
Lanczos (rango k, dispersa) |
O(k · nnz(A)) |
Lo mismo, cuando A es dispersa |
Tres consecuencias merecen decirse en voz alta, porque cada una es un error que cuesta una sola línea de código:
- Factoriza una vez, resuelve muchas. Cholesky cuesta
n³/3una vez; cada resolución posterior son dos sustituciones triangulares aO(n²). Así quemtérminos independientes cuestanO(n³ + mn²), noO(mn³).np.linalg.inv(A) @ Bes a la vez más lento y menos preciso que factorizar, y nunca es la decisión correcta. - Las ecuaciones normales elevan al cuadrado el número de condición, porque
κ(XᵀX) = κ(X)². El error de QR escala conκ(X)·ε; el de las ecuaciones normales, conκ(X)²·ε. Los mismos datos, el mismo objetivo, el error al cuadrado. - No calcules lo que vas a tirar. Una SVD completa es
O(mn·min(m,n)). Si quieres 20 componentes de 1682, la SVD aleatorizada esO(mnk)y Lanczos esO(k·nnz(A)). Esa distancia es la razón de que los recomendadores a gran escala sean viables.
La misma página lleva la otra mitad de esto: su portal de la SVD pone la circunferencia unidad y su imagen una al lado de la otra, así que A vᵢ = σᵢ uᵢ es algo a lo que llegas desplazando y no algo que te cuentan, y σ₁/σ₂ es una forma en la pantalla y no un cociente. El elipsoide que viene después es la misma imagen una dimensión más arriba, y los dos pasos siguientes, colineal y float32, son las dos consecuencias de arriba dibujadas: β yendo y volviendo mientras dos columnas se cierran una sobre otra, y las ecuaciones normales dividiendo exactamente por cero cuando un formato numérico ya no las distingue.
El escenario del tensor de audio lleva las otras dos factorizaciones de esta tabla, medidas y no citadas. Rango bajo factoriza en tu navegador la propia matriz (513, 465) del apéndice E y reconstruye la curva de señal-ruido peldaño a peldaño mientras lo hace, así que la espera es el coste por el que pregunta esta sección. Partes con nombre ajusta NMF a una matriz del mismo tipo e imprime su error junto al de la SVD truncada con el mismo rango —peor, como dice que tiene que ser Eckart–Young— y después te deja aislar una componente y oír qué compró esa fracción de un punto porcentual.
# TODO 1: Fit a degree-10 polynomial to the real airline series two ways.
#         X = np.vander(month_scaled, 11, increasing=True); y = passengers
#         a) normal equations: np.linalg.solve(X.T @ X, X.T @ y)
#         b) QR: Q, R = np.linalg.qr(X); np.linalg.solve(R, Q.T @ y)
#         Use np.linalg.lstsq as the reference. Compare the RESIDUALS, then
#         compare the COEFFICIENTS. Only one of those two comparisons sees
#         the problem.
# TODO 2: Build the 1797x1797 RBF kernel matrix of the digits plus a ridge
#         term, and 200 right-hand sides. Time three strategies: factor once
#         with cho_factor/cho_solve, np.linalg.inv(G) @ B, and one
#         np.linalg.solve per column. Print the ratios, and the relative
#         residual of the first two. Which is both faster AND more accurate?
# TODO 3: Time Cholesky, LU, QR, eigh and SVD across n = 128 ... 768. Fit
#         log t against log n; the slope is the measured exponent. Compare
#         it against the predicted 3, and compare the measured SVD/Cholesky
#         ratio against the 39x the table above predicts. Which of the two
#         predictions survives contact with a real machine?
# TODO 4: Write needed_rank(A, target_db) returning the smallest k whose
#         rank-k truncation reaches a target PSNR — WITHOUT rebuilding the
#         truncation for each k. Eckart-Young gives the squared error as
#         sum(S[k:] ** 2) directly. Run it on the 512x512 astronaut image
#         for 20, 25, 30 and 35 dB and report what each rank costs to store.
Solución
X = np.vander(month_scaled, 11, increasing=True)                   # TODO 1
beta_normal = np.linalg.solve(X.T @ X, X.T @ passengers)
Q, R = np.linalg.qr(X); beta_qr = np.linalg.solve(R, Q.T @ passengers)
beta_ref = np.linalg.lstsq(X, passengers, rcond=None)[0]
# cond(X) = 2.2e+07, cond(X.T @ X) = 4.6e+14 — the square, to one digit
# residuals agree to six decimals; coefficient errors are 2.0e-03 vs 2.0e-14

X_fast = cho_solve(cho_factor(G), B)                               # TODO 2
# factor once = 1x; explicit inverse ~5x slower; one solve per column ~340x
# and the explicit inverse is also ~7x less accurate on the residual

slope, _ = np.polyfit(np.log(sizes), np.log(times), 1)             # TODO 3
# fitted slopes land near 2.2-2.9, not 3.0; and the measured SVD/Cholesky ratio lands well under the predicted 39x

S = np.linalg.svd(A, compute_uv=False)                             # TODO 4
tail = np.concatenate([np.cumsum(S[::-1] ** 2)[::-1], [0.0]])
with np.errstate(divide="ignore"):        # the last entry is exactly 0
    db = 10 * np.log10(1.0 / (tail / A.size))
k = int(np.argmax(db >= target_db))
El TODO 1 es el caro. Los residuos de los dos ajustes coinciden en seis decimales, así que la comprobación que hace casi todo el mundo no señala ningún problema. Mientras tanto, los coeficientes difieren en once órdenes de magnitud. Esa distancia es exactamente κ(X)² frente a κ(X), y vino de escribir X.T @ X.
El TODO 3 no te da 3,0, y eso no es un fallo de la teoría. Los exponentes ajustados salen bajos porque tanto el paralelismo como la reutilización de caché mejoran al crecer n. La máquina se vuelve más rápida haciendo el mismo trabajo, y eso aplana la curva. El efecto se encoge con n mayores, así que la pendiente va subiendo. Lo que sí sobrevive es la razón entre métodos a n fijo. Cancela la máquina, porque los dos métodos ganan con el mismo hardware. Predice con razones, no con exponentes.
uint8 de 512×512. Es el 6,3 % del número de píxeles, pero el 12,5 % de los bytes en int16, y el 25 % en float32. La SVD truncada es una herramienta de análisis excelente y un códec de imagen mediocre.
Pausa (5 min)
10 · Descomposición de Tucker con datos reales (Bloque 6, 15 min)
Practica hoy: Explicar formas del núcleo y factores, medir almacenamiento y error, y elegir rangos Tucker según un límite de error.
Explora después: Implementar HOSVD e inspeccionar desplegados, interacciones del núcleo y barridos de rangos.
La teoría
PCA comprime una matriz: dos ejes. Los datos reales a menudo tienen más. La descomposición de Tucker generaliza PCA a un tensor de cualquier orden: una matriz de factores por eje, más un tensor núcleo pequeño que describe cómo se combinan los factores.
La forma de calcularla, llamada HOSVD, usa solo herramientas que ya tienes:
- Desplegar el tensor por cada eje (Parte I).
- Ejecutar la SVD sobre cada desplegado y quedarse con las componentes principales. Esas son las matrices de factores.
- Contraer el tensor original contra todas las matrices de factores para obtener el núcleo (sección 06).
La descomposición CP, emparentada con ella, escribe en cambio el tensor como suma de piezas simples de rango 1. Tucker suele ser más precisa al mismo tamaño; CP suele ser más fácil de interpretar.
Nuestro tensor real. Con 6433 viajes reales en taxi de Nueva York construimos un tensor de orden 3 genuino: distrito de recogida × distrito de destino × hora del día.
Ejercicio (10 min)
taxis['hour'] = pd.to_datetime(taxis['pickup']).dt.hour
sub = taxis.dropna(subset=['pickup_borough', 'dropoff_borough'])
pb = sorted(sub['pickup_borough'].unique())
db = sorted(sub['dropoff_borough'].unique())

T = np.zeros((len(pb), len(db), 24))
for (p, d, h), v in sub.groupby(['pickup_borough','dropoff_borough','hour']).size().items():
    T[pb.index(p), db.index(d), h] = v

# TODO 1: Print T.shape and T.sum(). What does the entry T[i, j, k] mean?
# TODO 2: Which hour has the most trips overall? (Sum over the first two axes.)
# TODO 3: Unfold T along each axis and print the three shapes. Confirm the total
#         number of entries is the same each time — unfolding loses nothing.
# TODO 4: Run SVD on each unfolding, keep the top (2, 2, 3) components, and build
#         the core tensor with ONE einsum call.
# TODO 5: Reconstruct T from the core and factors, again with one einsum.
#         Compute the relative error and the compression ratio.
# TODO 6: Look at the first column of the hour factor matrix. At which hour is it
#         largest? Does that match what you found in TODO 2?
Explicación (5 min)
Us = [np.linalg.svd(unfold(T, ax), full_matrices=False)[0] for ax in range(3)]
r = (2, 2, 3)
Us = [Us[i][:, :r[i]] for i in range(3)]

core  = np.einsum('ijk,ia,jb,kc->abc', T, Us[0], Us[1], Us[2])   # (2, 2, 3)
recon = np.einsum('abc,ia,jb,kc->ijk', core, Us[0], Us[1], Us[2])

error = np.linalg.norm(T - recon) / np.linalg.norm(T)            # 0.067
ratio = T.size / (core.size + sum(u.size for u in Us))            # 4.71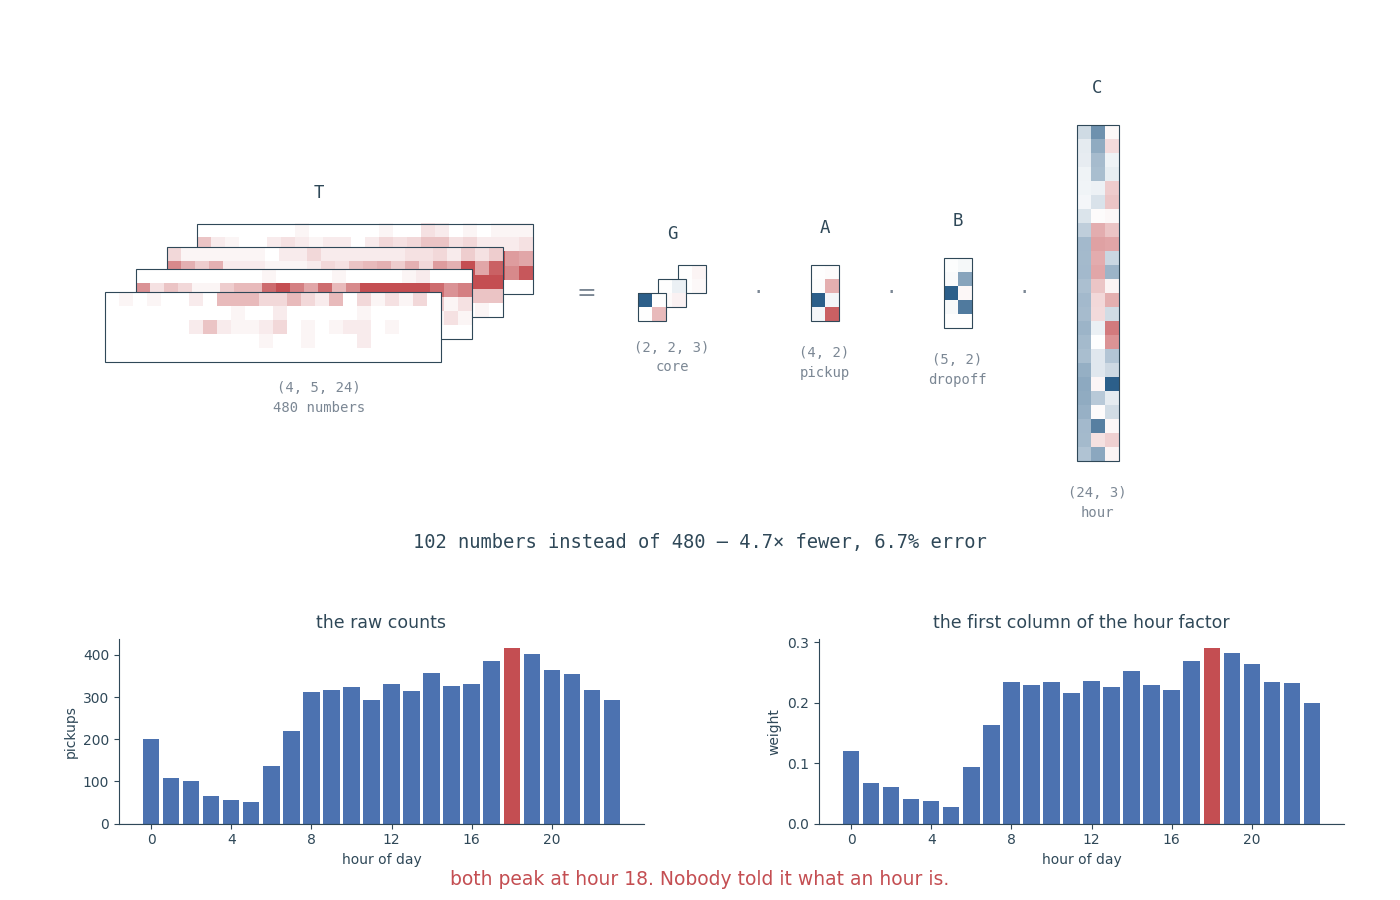
480 números se convierten en 102. Los dos diagramas son el TODO 6. A la izquierda, la hora con más viajes en los recuentos brutos. A la derecha, el pico del factor de hora, que la descomposición construyó sin que nadie le dijera nunca qué es una hora.
El resultado: 4,7× menos números, 6,7 % de error. Pero lo importante es el TODO 6. El patrón más fuerte del factor de hora tiene su pico en la hora 18, y esa es también la hora con más viajes en los datos brutos. La descomposición encontró la hora punta de la tarde sin que nadie le dijera qué es una hora. Es lo esperable, no magia: cada entrada es un conteo de viajes, así que el patrón más fuerte del eje de horas sigue lo concurrida que está cada hora. Encontró el patrón dominante en ese eje, porque eso es lo que hace una descomposición. El escenario de Tucker y CP ejecuta esta misma descomposición en vivo, sobre este mismo tensor, con los tres rangos como deslizadores, de modo que estos 480 → 102, 4,71× y 6,7 % de esta tabla se mueven bajo tu propia mano al cambiarlos.
Fíjate en las cadenas de einsum: 'ijk,ia,jb,kc->abc' contrae tres ejes en una sola expresión. Por eso einsum vino antes.
Dónde se usa esto. En tecnología, Tucker y CP comprimen los grandes tensores de pesos que hay dentro de las redes neuronales. Así los modelos corren en teléfonos en lugar de en servidores. En biotecnología, aplicados a datos como (genes × muestras × condiciones), encuentran estructura a la que el PCA corriente no llega, porque el PCA solo puede ver dos ejes. Para proyectos reales usa tensorly, que implementa las dos correctamente. Consulta las referencias para el artículo de revisión de Kolda y Bader, y para el teorema de Eckart–Young que hay debajo de ambas descomposiciones.
Kahoot 3 — Convolución y descomposiciones tensoriales (5 min)
Hazlo justo después de la sección 10, antes de la sección 11. Sus seis preguntas siguen cubriendo convolución y correlación junto con Tucker y CP. La convolución pasó a ser el ejercicio para casa 13 cuando las factorizaciones entraron en la jornada, y las preguntas todavía no se han reescrito. Hazlo mientras el resultado de la hora punta del tensor de taxis siga en pantalla. Lanza kahoot_quiz_3_convolution_decompositions.xlsx (6 preguntas, ~5 min) y pasa directamente del podio a la sección 11, que lleva el mismo tensor a CP.
11 · Factorizaciones tensoriales: cuál elegir y qué cuesta (Bloque 7, 15 min)
Practica hoy: Comparar CP y Tucker sobre el mismo tensor mediante conteos de parámetros, errores de reconstrucción y diferencia de presupuestos.
Explora después: Estudiar Tensor Train y t-SVD, investigar unicidad de CP y comprimir capas de redes neuronales.
La sección 09 preguntó qué factorización y qué cuesta un orden más abajo, sobre matrices. Esta sección se lo pregunta a los tensores, justo después de que la sección 10 haya enseñado una respuesta. El cuaderno es 11 · Factorizaciones tensoriales.
Una descomposición tensorial no es solo una técnica de compresión. Cada una hace una suposición distinta sobre qué estructura de los datos hay que conservar, y esa suposición —no el recuento de operaciones— es entre lo que eliges.
Cuatro descomposiciones, cuatro tratos
| Método | Idea principal | Almacenamiento | Cuándo encaja mejor |
|---|---|---|---|
| CP | Suma de componentes de rango 1 | R(I + J + K) |
Componentes interpretables una a una; la unicidad puede importar |
| Tucker / HOSVD | Un subespacio de baja dimensión por modo, más un núcleo | R₁R₂R₃ + IR₁ + JR₂ + KR₃ |
Modos distintos necesitan rangos distintos |
| Tensor Train (TT) | Cadena de núcleos pequeños | ≈ O(N · I · r²) |
Tensores de orden muy alto |
| t-SVD | FFT sobre el modo 3, SVD matriciales, FFT inversa | Depende del rango tubular conservado | Tensores de orden 3 con un tercer modo con significado |
Cada método conserva una estructura distinta. CP busca componentes individuales. Tucker permite un rango diferente por modo. Tensor Train evita que un núcleo de orden alto crezca exponencialmente, y t-SVD conserva la estructura del tercer modo mediante FFT.
¿Por qué no aplanar primero?
Aplanar conserva los valores numéricos, pero puede esconder el significado que llevan los modos separados del tensor. El ejemplo sintético de separación de fluorescencias del cuaderno hace medible la diferencia:
- CP recupera las cantidades reales de cada componente con correlación
1.00. - Aplanar y luego aplicar SVD llega solo a
|corr| ≈ 0,536de media. - La representación por SVD puede producir direcciones de cantidad negativas, aunque una concentración física no puede ser negativa.
Ese ejemplo es sintético a propósito: aísla la pregunta estructural sin exigir descargar otro conjunto de datos.
Aplanar no es necesariamente incorrecto. El problema aparece cuando fusionamos dos modos cuyo significado separado era precisamente la información que queríamos interpretar.
Comparación justa: CP frente a Tucker
No compares el rango CP R contra el rango Tucker (R, R, R). Esas dos representaciones almacenan un número distinto de parámetros, así que la comparación mide el presupuesto, no el modelo. Un experimento justo es:
- elegir un rango CP;
- contar sus parámetros almacenados,
R · sum(T.shape); - buscar rangos de Tucker cercanos a ese mismo presupuesto de parámetros y quedarse con el de menor error de reconstrucción;
- comparar error e interpretabilidad con ese presupuesto igualado.
El paso 3 es donde esto se tuerce con más facilidad. Elegir el candidato cuyo número de parámetros sea simplemente el más cercano al presupuesto puede regalarle a Tucker un modo degenerado de rango 1, y fabricar la conclusión. El cuaderno hace la comparación de esta forma sobre el tensor real de taxis de Nueva York, distrito de recogida × distrito de destino × hora. Usa el clip de tormenta fijado del taller como segundo ejemplo con forma de tensor. La imagen del presupuesto del escenario de Tucker y CP dibuja exactamente esto: el error de CP frente a su número de parámetros para R = 1 a 6, una nube con cada trío de rangos de Tucker que cabe en cada presupuesto, y un interruptor entre mejor error y parámetros más cercanos para que veas a esta segunda regla regalarle a Tucker un eje degenerado de rango 1 sobre el mismo tensor del que trata esta sección.
# TODO 1: Choose a CP rank R for the taxi tensor.
# TODO 2: Count CP parameters: R * sum(T.shape).
# TODO 3: Search Tucker ranks near that parameter count and keep the one with
#         the lowest reconstruction error, not merely the closest parameter
#         count. Watch what a rank-1 mode does to the answer.
# TODO 4: Compare relative reconstruction error at the matched budget.
# TODO 5: Explain which set of factors is easier to interpret.
Por qué Tensor Train importa cuando crece el orden
Para un tensor denso de orden N con todos los modos de tamaño I, el almacenamiento denso es I^N. Con un rango de enlace TT fijo r, el almacenamiento TT es ≈ O(N · I · r²): exponencial en el orden frente a lineal en el orden, con I y r fijos.
El almacenamiento de CP también es lineal en el orden bajo un rango global fijo. La ventaja práctica de TT es distinta. Representa interacciones de orden alto mediante rangos de enlace locales, en vez de mediante un único núcleo de Tucker que crece exponencialmente con el orden.
# TODO 1: Fix I and the TT bond rank r.
# TODO 2: Increase the tensor order N.
# TODO 3: Plot dense storage I**N against TT storage ~ N*I*r**2.
# TODO 4: Explain the different growth rates, and where the crossover sits.
Descomposición tensorial dentro de las redes neuronales
Un núcleo de convolución denso de forma 3 × 3 × 512 × 512 guarda 2 359 296 pesos, y cuesta unos 462 millones de multiplicaciones-sumas sobre un mapa de características de 14 × 14. Una factorización CP de rango 64 guarda 64 × (3 + 3 + 512 + 512) = 65 920 pesos —35,8× menos— y se ejecuta como cuatro convoluciones estrechas en secuencia: 1×1 → 3×1 → 1×3 → 1×1.
Un orden más arriba, una matriz de salida de transformer W_O de forma 4096 × 4096 guarda 16 777 216 pesos. Una representación TT-matriz de rango 16 guarda 34 816, es decir, 481,9× menos.
La razón de almacenamiento es la mitad fácil. El flujo de trabajo que lo hace utilizable es entrenar → comprimir → afinar. La compresión no te sirve de nada si la tarea final no sigue siendo lo bastante precisa, y eso es una propiedad de los pesos entrenados, no de la forma.
# TODO 1: Build the synthetic convolution kernel from notebook 13.
# TODO 2: Evaluate several CP ranks.
# TODO 3: Find the smallest rank whose reconstruction error sits below a
#         threshold you chose in advance.
# TODO 4: Report the rank, the error, the stored weights and the compression
#         ratio — all four, because any one of them alone can be gamed.
La regla de decisión
Elige la descomposición según la estructura que necesitas conservar, y después elige el rango según la pérdida que puedes permitirte. Mantén ese orden. La primera pregunta no tiene respuesta numérica, y la segunda no tiene respuesta en absoluto hasta que la primera está resuelta.
Para el tratamiento interactivo completo —selector de método, tiempos medidos, comparación CP/Tucker con presupuesto igualado, compresión aguas abajo y el widget de presupuesto de almacenamiento— sigue con 11 · Factorizaciones tensoriales.
Sigue abierto: el rango de la multiplicación de matrices 3 × 3
Multiplicar dos matrices 2 × 2 a la manera escolar cuesta 8 multiplicaciones. En 1969 Volker Strassen lo hizo con 7. Aplicada a bloques, una y otra vez, esa multiplicación ahorrada baja el coste de un producto n × n de n³ a n^2.807, porque log₂ 7 = 2.807. Dos años después, Winograd demostró que 7 es el mínimo posible.
Ese 7 es un rango CP. La multiplicación de matrices es una contracción, como mostró la sección 06, y un tensor fijo de ceros y unos dice qué productos suma. Para matrices 2 × 2 ese tensor es 4 × 4 × 4, con un 1 por cada uno de los 8 productos escolares. Cada término de rango uno de una descomposición CP cuesta una multiplicación, así que una descomposición de rango R es un algoritmo con R multiplicaciones. El algoritmo de Strassen son siete términos de rango uno que suman exactamente el tensor. El código de abajo construye el tensor, comprueba que contraerlo multiplica y comprueba los siete términos de Strassen:
import itertools

import numpy as np

def matmul_tensor(n):
    # One 1 for each schoolbook product A[i, k] * B[k, j], added into C[i, j].
    M = np.zeros((n * n, n * n, n * n), dtype=int)
    for i, j, k in itertools.product(range(n), repeat=3):
        M[i * n + k, k * n + j, i * n + j] = 1
    return M

M2, M3 = matmul_tensor(2), matmul_tensor(3)
print(M2.shape, M2.sum(), M3.shape, M3.sum())  # (4, 4, 4) 8 (9, 9, 9) 27

# Contract M3 with two flattened 3 x 3 matrices, and out comes their product.
rng = np.random.default_rng(0)
A, B = rng.random((3, 3)), rng.random((3, 3))
C = np.einsum("abc,a,b->c", M3, A.ravel(), B.ravel()).reshape(3, 3)
print(np.allclose(C, A @ B))  # True

# Strassen's seven products. Row r of U and of V says which entries of A and
# of B product r adds up before it multiplies; row r of W says which entries
# of C it is added to (1) or subtracted from (-1). Order: 11, 12, 21, 22.
U = np.array([[1, 0, 0, 1], [0, 0, 1, 1], [1, 0, 0, 0], [0, 0, 0, 1],
              [1, 1, 0, 0], [-1, 0, 1, 0], [0, 1, 0, -1]])
V = np.array([[1, 0, 0, 1], [1, 0, 0, 0], [0, 1, 0, -1], [-1, 0, 1, 0],
              [0, 0, 0, 1], [1, 1, 0, 0], [0, 0, 1, 1]])
W = np.array([[1, 0, 0, 1], [0, 0, 1, -1], [0, 1, 0, 1], [1, 0, 1, 0],
              [-1, 1, 0, 0], [0, 0, 0, 1], [1, 0, 0, 0]])
print(np.array_equal(np.einsum("ra,rb,rc->abc", U, V, W), M2))  # True: rank <= 7
El escenario de AlphaTensor es esta nota en doce imágenes. Suma los siete términos de Strassen a un cubo vacío de uno en uno y la cuenta de celdas equivocadas sube, de 8 a 12, antes de bajar a cero: los términos se pasan y se cancelan. Después dale la vuelta a la suma y juégala como un juego, restando términos hasta que no quede nada. Ese es el juego que juega AlphaTensor, y un jugador que siempre elige la jugada que mejor se ve encuentra ocho términos y nunca siete. El estudio a fondo 20 hace la misma aritmética en NumPy, y luego carga las descomposiciones que publicó DeepMind y las comprueba.
Para matrices 3 × 3 el tensor es 9 × 9 × 9, con 27 unos, y nadie conoce su rango. Es al menos 19 (Bläser, 2003) y como mucho 23 (Laderman, 1976). Un rango 21 superaría a Strassen: recurrir sobre bloques 3 × 3 costaría n^2.771. Un rango 22 no, con n^2.814.
Por qué vale dinero. La multiplicación densa de matrices es la operación central al entrenar y al usar una red neuronal, así que una más barata le importa a quien paga el hardware. DeepMind ha buscado descomposiciones de rango bajo de estos tensores dos veces, con AlphaTensor (2022) y AlphaEvolve (2025). Según Tamara Kolda, ninguna superó el mejor exponente práctico conocido en su momento, el de Smirnov de 2013. Además, el exponente solo cuenta multiplicaciones: un algoritmo rápido también tiene que ganar en sumas, tráfico de memoria y error de redondeo antes de que una biblioteca lo adopte.
Kolda, coautora de la revisión por la que la página de referencias te dice que empieces, plantea el problema 9 × 9 × 9 a su público al menos desde 2015, y volvió a plantearlo el 28 de septiembre de 2026 como prueba para la IA: An Open Problem to Challenge AI Math Skills. Grey Ballard, su coautor, conjetura que el rango es 23, así que lo que falta quizá sea una demostración de que no existe nada más corto. Su entrada enumera los mismos 27 unos, contados desde 1 y con los dos primeros ejes numerados por columnas en lugar de por filas; renumerar un eje no puede cambiar un rango. Los artículos que respaldan cada cifra de esta nota están en Un problema abierto, en la página de referencias, junto con un catálogo de las mejores descomposiciones conocidas para cada tamaño pequeño.
12 · Cierre (5 min)
Practica hoy: Aplicar razonamiento sobre ejes a datos nuevos y explicar por qué Tucker recupera la forma mientras pierde información.
Explora después: Elegir trabajo posterior sobre PCA, atención, CP, Cholesky, audio o los estudios 13–16.
Lo que has hecho hoy:
- Parte I: leer una fotografía real como un tensor: forma
(512, 512, 3), 786 432 números, y un eje que se conoce por lo que significa además de por su tamaño. - Parte II: barajar un lote de dígitos y un clip de vídeo con la misma permutación: los dígitos conservaron sus etiquetas y el vídeo perdió su historia, porque el eje de lote y el eje de tiempo son ejes de distinto tipo.
- Parte III: estandarizar 1797 dígitos con broadcasting y tropezar con los píxeles que nunca varían y se convierten en NaN; mover el eje de canal de imágenes reales de microscopía y cazar el único
reshapeque corre sin error y desordena una fotografía; y quedarse con 16 de los 720 fotogramas de un vídeo real, cada uno rastreado hasta el fotograma del que salió. - Parte IV: pasar una imagen en color a gris con un solo
einsum; ver cómo la pseudoinversa elige la más pequeña de muchas respuestas igual de buenas cuando dos columnas son copia una de la otra; calcular Fibonacci como una potencia de matriz; ajustar el tráfico aéreo real por QR y por las ecuaciones normales, y descubrir residuos parecidos que esconden coeficientes distintos; y reducir un tensor real de taxis de 480 conteos a 60 números con Tucker, conservando un único patrón diario con su pico en la hora 18, antes de que CP ganara el mismo juego al bajar el umbral de error al 2 %.
Una sola idea conecta las secciones 07, 09 y 10: cuando un problema no tiene respuesta exacta ni inversa verdadera, no te rindes: buscas la mejor aproximación estable. Esas tres secciones la enuncian. La ves ocurrir tres veces: la pseudoinversa sobre dos columnas que son copia una de la otra en la sección 07, Tucker sobre el tensor de taxis en la sección 10, y Richardson-Lucy sobre una fotografía desenfocada en el ejercicio 13.
Adónde ir después
torch.einsum/tf.einsum/jnp.einsum: sintaxis idéntica a la que has usado hoy.np.linalg: el resto del capítulo 2 — descomposición espectral,lstsq,pinv,qr,cholesky.scipy.signalyskimage.restoration: convolución y deconvolución más allá de hoy.- Los cinco ejercicios para casa, apéndices A a E —PCA, atención, CP, Cholesky y eliminación de ruido en audio—, todos en el cuaderno 12.
- Un estudio a fondo que va más allá: convolución y deconvolución (apéndice F, cuaderno 13), la tercera aparición de la idea que conecta el día de hoy, y la que la sala no llegó a ejecutar. Consulta el índice de cuadernos para ver todos los estudios a fondo para casa.
- Un problema abierto al final de la sección 11: un tensor
9 × 9 × 9de 27 unos cuyo rango nadie conoce, y por qué vale la pena encontrar una multiplicación de matrices más barata. - Referencias y lecturas adicionales: libros, los artículos fundacionales sobre Tucker/CP/SVD,
tensorlyy las entradas del blog, para profundizar más allá de los 210 minutos de hoy.
🇪🇸 Ese es todo el taller. Gracias por participar.
Ya tienes una forma práctica de pensar sobre tensores: primero el significado de los ejes, después la operación matemática.
Lecturas adicionales
La bibliografía se mudó a su propia página, en los dos idiomas: Referencias y lecturas adicionales.
Lleva lo que esta sección llevaba antes —los libros de álgebra lineal, el artículo de revisión de Kolda y Bader, los artículos de Tucker, CP/PARAFAC y Eckart–Young con sus DOI y páginas de autor, y la documentación de tensorly— más las entradas del blog de ML que enlazan las diapositivas, que nunca estuvieron listadas aquí. Ahora cada obra se cita en un solo sitio, y la mitad española del sitio puede llegar a ella.
Salta directamente a un grupo: álgebra lineal · tensores · un problema abierto · software · el blog de ML.
El complemento generado por máquina es otra cosa distinta y vive en su propia página: generado, no escrito, y para contrastarlo contra las obras de esa página, no al revés.
Apéndice A — Para casa: ¿cuántas componentes principales bastan?
Aquí los datos reales esconden una trampa. Encuéntrala.
bc = load_breast_cancer(); X, y = bc.data, bc.target

# TODO 1: Center X, run np.linalg.svd, and compute the fraction of variance each
#         component explains (variance is proportional to S**2).
# TODO 2: How many components explain 95% of the variance? The answer will look
#         TOO GOOD. Do not trust it yet.
# TODO 3: Print X.var(axis=0). The 30 measurements use different units — some are
#         areas in the thousands, some are ratios below 1. What is that doing?
# TODO 4: Redo everything on standardized data: (X - mean) / std. How many now?
# TODO 5: Scatter-plot the first 2 components, coloured by y. Do the two groups separate?
Solución
Xc = X - X.mean(axis=0)
S = np.linalg.svd(Xc, full_matrices=False)[1]
n95 = np.argmax(np.cumsum(S**2/(S**2).sum()) >= 0.95) + 1      # 1  (!)

Xs = (X - X.mean(axis=0)) / X.std(axis=0)
S2 = np.linalg.svd(Xs, full_matrices=False)[1]
n95_scaled = np.argmax(np.cumsum(S2**2/(S2**2).sum()) >= 0.95) + 1 # 10worst area tiene una varianza de unos 323 000, y los valores de suavidad están por debajo de 1. Así que el PCA informa de la mayor unidad, no del mayor patrón. Después de estandarizar, la primera componente explica el 44 % y hacen falta 10 componentes. El PCA no sabe nada de unidades. Las variables en escalas distintas hay que estandarizarlas primero.
Apéndice B — Para casa: la atención son dos contracciones
La atención responde a la pregunta 5 de la discusión sobre el pipeline de vídeo: ¿qué partes de una secuencia importan más? Los modelos de lenguaje de proteínas la usan para que cada aminoácido pueda mirar a todos los demás. Los recomendadores la usan para ponderar las interacciones pasadas de un usuario.
np.random.seed(6)
batch, seq_len, dim = 4, 12, 16
Q, K, V = (np.random.randn(batch, seq_len, dim) for _ in range(3))

def softmax(x, axis=-1):
    x = x - x.max(axis=axis, keepdims=True)
    e = np.exp(x); return e / e.sum(axis=axis, keepdims=True)

# TODO 1: With einsum, compute scores[b,i,j] = how much position i attends to
#         position j. Shape (4, 12, 12). Scale by 1/sqrt(dim).
# TODO 2: Apply softmax on the correct axis so each row of weights sums to 1.
# TODO 3: With einsum, combine V using those weights -> (4, 12, 16).
# TODO 4: Suppose the last 3 positions are padding, not real data. Build a mask,
#         set those scores to -np.inf BEFORE the softmax, and verify the padded
#         positions receive exactly zero weight.
Pruébalo primero en el escenario de atención: las mismas dos contracciones, con una secuencia de cuatro lo bastante pequeña para sumar a mano, las puntuaciones dibujadas como un mapa de calor y la máscara causal de softmax dando ceros exactos en vez de pesos positivos pequeños.
Solución
scores  = np.einsum('bid,bjd->bij', Q, K) / np.sqrt(dim)
weights = softmax(scores, axis=-1)
output  = np.einsum('bij,bjd->bid', weights, V)

mask = np.zeros((seq_len, seq_len)); mask[:, -3:] = -np.inf
weights_masked = softmax(scores + mask, axis=-1)     # padded positions get weight 0
scores es el producto escalar del capítulo 2 (ec. 2.8); output es la combinación lineal del capítulo 2 (ec. 2.28). La atención son dos contracciones construidas con ideas que ya has leído. El TODO 4 resuelve el problema de la longitud variable de la Parte II: la máscara es como los modelos reales manejan secuencias y vídeos de distinta duración.
Apéndice C — Para casa: CP frente a Tucker
El ejercicio de CP frente a Tucker que vivía aquí se mudó a la propia sesión, como 11 · Factorizaciones tensoriales. Allí CP y Tucker se comparan con un presupuesto de parámetros equivalente en lugar de rango contra rango, y el análisis se amplía a Tensor Train y t-SVD. La sección 11 es el texto que acompaña a ese cuaderno, y el escenario de Tucker y CP ejecuta toda la comparación en vivo en el navegador, sobre el mismo tensor de taxis, sin necesidad de abrir ningún cuaderno.
Apéndice D — Para casa: Cholesky construye datos correlacionados
La sección 09 cubre Cholesky como resolvedor: factorizar una vez y luego resolver barato muchas veces. Este apéndice es la otra mitad: Cholesky como muestreador. Dale a una L triangular inferior con L @ L.T == Sigma un poco de ruido gaussiano independiente, y te devuelve muestras correlacionadas con exactamente esa covarianza. Ese es el mecanismo detrás de toda simulación de Monte Carlo que necesite activos, sensores o escenarios correlacionados.
vol = np.array([0.012, 0.015, 0.010])
corr = np.array([[1.00, 0.85, 0.20],
                  [0.85, 1.00, 0.20],
                  [0.20, 0.20, 1.00]])
Sigma = np.outer(vol, vol) * corr

weights = np.array([0.4, 0.4, 0.2])
mu = np.array([0.00030, 0.00035, 0.00020])
n_days, n_paths, initial_value = 252, 20_000, 100.0

rng = np.random.default_rng(5)
sample_sizes = [100, 1_000, 100_000]

# TODO 1: L = np.linalg.cholesky(Sigma). Verify np.allclose(L @ L.T, Sigma).
# TODO 2: For each n in sample_sizes, draw z = rng.standard_normal((3, n)),
#         build x = L @ z, and track the Frobenius error between np.cov(x)
#         and Sigma as n grows. For the largest n, print np.cov(z) (≈ identity)
#         and np.cov(x) (≈ Sigma).
# TODO 3: Simulate a correlated portfolio: z_paths = rng.standard_normal(
#         (3, n_days * n_paths)); correlated_asset_returns = mu[:, None] +
#         L @ z_paths, reshaped to (3, n_paths, n_days); combine with weights
#         into daily portfolio returns; compound into terminal_correlated.
# TODO 4: Repeat with independent_scale = np.diag(np.sqrt(np.diag(Sigma)))
#         instead of L, reusing the SAME z_paths, to get terminal_independent.
# TODO 5: Plot both terminal distributions as overlaid histograms.
# TODO 6: Compare std, 5th and 1st percentiles of both distributions.
Solución
L = np.linalg.cholesky(Sigma)
print(np.allclose(L @ L.T, Sigma))          # True

errors = []
for n in sample_sizes:
    z = rng.standard_normal((3, n))
    x = L @ z
    errors.append(np.linalg.norm(np.cov(x) - Sigma))
print(errors[0] > errors[1] > errors[2])    # True — error shrinks as n grows

z_paths = rng.standard_normal((3, n_days * n_paths))
correlated_asset_returns = (mu[:, None] + L @ z_paths).reshape(3, n_paths, n_days)
portfolio_returns_correlated = np.einsum('a,apd->pd', weights, correlated_asset_returns)
terminal_correlated = initial_value * np.prod(1 + portfolio_returns_correlated, axis=1)

independent_scale = np.diag(np.sqrt(np.diag(Sigma)))
independent_asset_returns = (mu[:, None] + independent_scale @ z_paths).reshape(3, n_paths, n_days)
portfolio_returns_independent = np.einsum('a,apd->pd', weights, independent_asset_returns)
terminal_independent = initial_value * np.prod(1 + portfolio_returns_independent, axis=1)
Cov(x) = Cov(Lz) = L Cov(z) L.T ≈ L I L.T = L L.T = Sigma: entra ruido independiente, sale ruido correlacionado. Con los parámetros de arriba, la desviación típica del valor final de la simulación correlacionada es de ≈18,8 frente a ≈13,6 de la independiente, un 39 % más de dispersión. Su percentil 5 es ≈79,7 frente a ≈86,9, y su percentil 1 ≈70,7 frente a ≈79,9. Los días malos de la cartera correlacionada son genuinamente peores. Y la volatilidad, la media y la mediana del valor final de cada activo son esencialmente iguales entre las dos simulaciones. Esto no es una ley general según la cual la correlación aumenta el riesgo. Es específico de este ejemplo, donde todos los pares están correlacionados positivamente. Ignorar un par correlacionado negativamente subestimaría el riesgo, no lo sobreestimaría. Lo que sí se generaliza es solo que suponer independencia cuando los activos no son independientes distorsiona las colas.
Apéndice E — Para casa: eliminar ruido de audio con una STFT de rango bajo
La SVD truncada es la aproximación de rango bajo óptima (Eckart–Young, en las referencias). Este apéndice es donde esa optimalidad deja de bastar. Corta una grabación de voz real en ventanas temporales cortas y solapadas, y pregunta qué frecuencias hay en cada una. Eso es la transformada de Fourier de tiempo corto, y su salida es una matriz, frecuencia × tiempo. Truncar la SVD de esa matriz conserva la estructura concentrada en las direcciones singulares principales y tira el resto. Si la voz está más concentrada ahí que el ruido, el resultado es más limpio. Si no lo está, has tirado la voz.
Cada uno de esos movimientos es una imagen del escenario del tensor de audio, calculada en el navegador a partir de esta misma grabación. Recorta una ventana del arreglo y muestra cómo se le aplica el perfil; le pregunta a esa ventana qué frecuencias hay en ella, dibujando los 1024 bins con la mitad especular en gris, que es por lo que la matriz de abajo tiene 513 filas y no 1024; y hace avanzar la ventana para que cada parada sea una columna de la (513, 465) que vas a factorizar. Reproduce allí la señal reconstruida con la superposición en ninguna y oirás por qué las ventanas tienen que solaparse. La propia truncación es la imagen de rango bajo: añade ese mismo ruido de 5 dB, factoriza la matriz mientras esperas, y reconstruye la curva de esta tabla punto a punto en vez de citarla.
Ser óptimo en ‖A − B‖_F no es lo mismo que ser óptimo en lo que a ti te importa, así que el criterio hay que medirlo, no suponerlo. Aquí el criterio es la relación señal-ruido frente a una referencia limpia conocida, y por eso el ruido se añade a propósito en lugar de encontrarse. La grabación es real y está fijada a un SHA-256; el ruido es sintético por diseño, porque solo una señal limpia conocida hace medible la SNR.
voz real → ruido controlado → matriz STFT → truncamiento SVD → ISTFT → SNR
VOICE_URL = ("https://raw.githubusercontent.com/pdx-cs-sound/wavs/"
             "ed5ebcbbbc2d11f0adddc9b50b78d581c29f738c/voice.wav")
VOICE_SHA256 = "2c4b4d9d5f90715fdbf599869a465d521638f40ca978b186df96f1543a4d67dc"

def snr_db(reference, estimate):
    return 10 * np.log10(np.sum(reference**2)
                         / np.sum((estimate - reference)**2))

# TODO 1: Download voice.wav, check its SHA-256 before using it, and refuse the
#         file if it does not match. Convert to float and mix down to mono.
# TODO 2: Add Gaussian noise scaled to a target SNR of 5 dB, then measure the
#         SNR you actually got. It should come back at 5 dB — that is the check
#         that your scaling is right.
# TODO 3: Take signal.stft(noisy, fs=fs, nperseg=1024, noverlap=512) and run
#         np.linalg.svd on it. The matrix is COMPLEX; svd handles that.
# TODO 4: For k in [2, 5, 10, 20, 40, 80, full_rank], rebuild the rank-k STFT,
#         invert it with signal.istft, and measure the SNR against `clean`.
# TODO 5: Plot SNR against k. It is not monotonic. Find the best k, and say
#         what is happening at BOTH ends of the curve.
# TODO 6: Why does full rank return exactly the SNR of the noisy input?
Solución
f, t, Z = signal.stft(noisy, fs=fs, nperseg=1024, noverlap=512)
U, s, Vh = np.linalg.svd(Z, full_matrices=False)          # Z.shape (513, 465)

for k in [2, 5, 10, 20, 40, 80, len(s)]:
    Zk = (U[:, :k] * s[:k]) @ Vh[:k, :]
    _, rec = signal.istft(Zk, fs=fs, nperseg=1024, noverlap=512)
    n = min(len(clean), len(rec))
    print(k, snr_db(clean[:n], rec[:n]), np.sum(s[:k]**2) / np.sum(s**2))
4,949 segundos a 48 kHz dan una STFT de (513, 465), así que el rango completo es 465. La entrada ruidosa mide 5,00 dB, tal y como se construyó:
| k | SNR | Energía conservada | |
|---|---|---|---|
| 2 | 2,29 dB | 33,2 % | peor que el ruido del que partimos |
| 5 | 4,76 dB | 51,1 % | todavía peor |
| 10 | 6,78 dB | 61,9 % | |
| 20 | 8,48 dB | 70,1 % | |
| 40 | 9,08 dB | 78,3 % | el mejor: +4,08 dB, con el 8,6 % del rango completo |
| 80 | 7,68 dB | 87,1 % | pasado el pico |
| 465 | 5,00 dB | 100 % | exactamente la entrada ruidosa otra vez |
Los dos extremos fallan, por razones opuestas. Con k = 2 la aproximación es tan agresiva que descarta voz junto con el ruido, y cae por debajo de la señal ruidosa: un «eliminador de ruido» que empeoró las cosas. Con el rango completo no se descarta nada en absoluto: U Σ Vᵀ reconstruye Z exactamente, la ISTFT invierte la STFT, y recuperas el audio ruidoso, 5,00 dB, sin cambios. La región útil es la de en medio, y el pico de aquí conserva el 78 % de la energía de los valores singulares con el 8,6 % de los rangos, que es la misma historia de compresión que el tensor de taxis de la sección 10, medida contra otro criterio.
k = 40 a k = 80 conserva más energía, un 87 % frente a un 78 %, y produce audio peor. La energía que se devuelve es ruido. Rango bajo no significa limpio; significa pequeño. Si además significa mejor es una pregunta empírica. Este es el único ejercicio para casa cuya respuesta es «solo dentro de una ventana, y hay que medir para encontrarla».
Apéndice F — Para casa: convolución y deconvolución
La teoría
La convolución desliza un array pequeño (el núcleo, o filtro) sobre otro más grande, multiplicando y sumando en cada posición. Es la operación en el corazón de toda red neuronal convolucional, y es también como funciona cualquier filtro de desenfoque, de enfoque o de detección de bordes.
x = np.array([1., 2., 3., 4., 5.])
k = np.array([1., 0., -1.])

np.convolve(x, k, 'full')    # [ 1.  2.  2.  2.  2. -4. -5.]  length 5+3-1 = 7
np.convolve(x, k, 'valid')   # [ 2.  2.  2.]                  length 5-3+1 = 3
np.convolve(x, k, 'same')    # [ 2.  2.  2.  2. -4.]          length 5
Tres modos, tres tamaños de salida. valid usa solo las posiciones donde el núcleo cabe entero: por eso la convolución encoge una imagen en kernel_size - 1.
⚠️ Un detalle que se le escapa a casi todo el mundo. La convolución verdadera voltea el núcleo; la correlación no. Lo que las bibliotecas de aprendizaje profundo llaman «convolución» es en realidad correlación. No supone ninguna diferencia práctica, porque la red aprende el núcleo, pero conviene saber que los nombres son inconsistentes.
np.correlate(x, k, 'valid')          # [-2. -2. -2.]
np.convolve(x, k[::-1], 'valid')     # [-2. -2. -2.] — the same, with k flipped
La convolución es una multiplicación matricial. Esta es la conexión de vuelta al capítulo 2. Cualquier convolución se puede escribir como multiplicación por una matriz de Toeplitz: una matriz donde el núcleo va desplazándose en cada fila:
col = np.zeros(7); col[:3] = k
row = np.zeros(5); row[0] = k[0]
C = toeplitz(col, row)                       # (7, 5)
np.allclose(C @ x, np.convolve(x, k, 'full'))   # True
Así que la convolución no es un tipo nuevo de operación. Es una multiplicación matricial estructurada, una en la que los mismos pocos números se reutilizan por toda la matriz. Esa reutilización es exactamente por qué las CNN necesitan muchos menos parámetros que las redes totalmente conectadas.
La deconvolución significa dos cosas distintas, y hay que mantenerlas separadas:
- Convolución transpuesta: la capa de sobremuestreo de un decodificador o de una GAN. Hace las cosas más grandes. No es una inversa verdadera; el nombre es histórico y engañoso.
- Deconvolución verdadera: recuperar la señal original a partir de una desenfocada. Este sí es un problema inverso genuino, y es donde vuelve la sección 07.
Ejercicio (10 min)
img = data.camera().astype(float) / 255.      # real photograph, 512x512
sobel = np.array([[-1,0,1],[-2,0,2],[-1,0,1]], float)

# TODO 1: Convolve `img` with `sobel` in 'valid' mode. What shape comes out,
#         and by how much did it shrink?
# TODO 2: Blur the image with a 9x9 averaging kernel (all entries equal,
#         summing to 1), mode='same'. Display it next to the original.
# TODO 3 (transposed convolution): upsample this 2x2 array to 3x3 by adding
#         small * kernel into an output array at each position:
#             small = np.array([[1., 2.], [3., 4.]]); ker = np.ones((2, 2))
#         What shape do you get? Why is this called "deconvolution" in CNNs
#         even though it does not undo anything?
# TODO 4 (true deconvolution): add small noise to the blurred image, then try to
#         recover the original with skimage.restoration.richardson_lucy(...,
#         num_iter=50). Measure error BEFORE and AFTER, ignoring a 25-pixel
#         border. Did it improve?
Explicación (5 min)
edges = signal.convolve2d(img, sobel, mode='valid')     # (510, 510) — shrank by 2

psf = np.ones((9, 9)); psf /= psf.sum()
blurred = signal.convolve2d(img, psf, mode='same', boundary='symm')
noisy = blurred + 0.002 * np.random.default_rng(0).standard_normal(blurred.shape)

from skimage.restoration import richardson_lucy
recovered = richardson_lucy(np.clip(noisy, 0, 1), psf, num_iter=50)

c = 25   # ignore the border: deconvolution always creates edge artifacts
err = lambda a: np.linalg.norm((a-img)[c:-c,c:-c]) / np.linalg.norm(img[c:-c,c:-c])
print(err(noisy), err(recovered))     # 0.1157 -> 0.0815
La deconvolución redujo el error alrededor de un 30 %. Dos lecciones que merece la pena guardar:
Primera: hay que ignorar el borde. La deconvolución crea artefactos fuertes en los bordes, donde el algoritmo no tiene información de lo que hay fuera de la imagen. Si mides el error sobre la imagen entera, los artefactos dominan y parece que el método ha fallado. No ha fallado.
Segunda: ¿por qué no invertir el desenfoque directamente? Porque falla estrepitosamente. Desenfocar destruye el detalle de alta frecuencia, así que invertirlo divide por números muy próximos a cero y amplifica el ruido enormemente:
K = np.fft.fft2(psf, s=img.shape)
naive = np.real(np.fft.ifft2(np.fft.fft2(noisy) / np.where(abs(K) < 1e-3, 1e-3, K)))
# relative error ≈ 1.4 — far WORSE than the blurred image we started from
Esta es la misma lección que la de la sección 07. Una inversa directa o no existe o es inutilizable, así que usas un método que encuentra la mejor respuesta estable. La pseudoinversa hace esto para sistemas lineales; Richardson-Lucy y el filtrado de Wiener lo hacen para la deconvolución. En biotecnología esto es rutina. Todo microscopio de fluorescencia desenfoca sus imágenes en una cantidad conocida, la función de dispersión de punto, y la deconvolución es práctica habitual antes de contar o medir células.
Apéndice G — Para casa: un gen ya es un tensor
La sección 04 reorganiza píxeles y la sección 06 los contrae. Este apéndice hace las dos cosas con otro tipo de datos, donde los ejes no son el espacio y el color sino la posición y el alfabeto — y donde el reshape y la contracción resultan ser, cada uno, todo un proceso biológico con nombre propio.
Un gen es una cadena sobre cuatro letras, así que se codifica one-hot como (L, 4): una fila por posición, un 1 por fila. Ese único paso es lo que permite que la aritmética toque una secuencia, y todo lo de abajo es una consecuencia de él.
Vale la pena predecir tres resultados antes de ejecutar nada. La transcripción es una matriz de 4 × 4, y cuál sea depende de con qué hebra la compares. La enzima lee la hebra molde y empareja cada base con su pareja, que es la 4 × 4 con una sola antidiagonal, porque en un eje alfabético intercambiar A con T y C con G es invertir el orden. El ARN que sale tiene las letras de la hebra codificante con U en lugar de T, y frente a esa hebra la matriz es la identidad: no se mueve ni un número, porque dos complementos se deshacen entre sí. Un codón es un tensor de rango uno: tres vectores one-hot multiplicados entre sí dan un 4 × 4 × 4 con exactamente un valor distinto de cero, el objeto más barato que aún necesita tres índices para direccionarse. Y el código genético es él mismo un 4 × 4 × 4, así que la traducción es una sola contracción sobre los tres ejes de bases — lo que además vuelve visible la redundancia del código como estructura y no como una lista: seis codones para la leucina, uno para la metionina, y una tercera base que a menudo no importa.
El último punto es la recompensa. Comparar una guía con cada ventana de una secuencia es einsum('wlb,lb->w'), porque el producto escalar de dos filas one-hot es 1 exactamente cuando las bases coinciden — de modo que sumar sobre posición y alfabeto cuenta coincidencias. Buscar es contraer. Hacerlo con muchas guías a la vez añade un índice por delante y no cambia nada más.
El escenario del genoma es todo esto en nueve imágenes; ve directo a la transcripción, al cubo de codones, a la tabla del código o a la búsqueda. Una de las nueve va un paso más allá de este apéndice: el pliegue es la proteína que codifica este gen tal como la predice AlphaFold, un arreglo (1300, 3), y la rejilla de distancias que sale de él es el broadcasting de la sección 03 sobre coordenadas reales. Es una página sobre cómo se representan los datos de secuencia, y deliberadamente no una herramienta para diseñar nada.
Ejercicio (15 min)
import numpy as np

BASES = "ACGT"
seq = "ATGTCAATTTATCAAGAATTTGTTAATAAATATAGTTTAAGT"   # 42 bases, 14 codons

def one_hot(s, alphabet=BASES):
    out = np.zeros((len(s), len(alphabet)), dtype=np.int8)
    out[np.arange(len(s)), [alphabet.index(c) for c in s]] = 1
    return out

X = one_hot(seq)                      # (42, 4), one 1 per row
assert X.sum(axis=1).min() == X.sum(axis=1).max() == 1

# The standard code as a (4, 4, 4) of residue indices on the same ACGT axis,
# written from the classic TCAG table so its block structure stays visible.
AAS, TCAG = "ACDEFGHIKLMNPQRSTVWY", "TCAG"
TABLE = ("FFLLSSSSYY**CC*W"            # T..
         "LLLLPPPPHHQQRRRR"            # C..
         "IIIMTTTTNNKKSSRR"            # A..
         "VVVVAAAADDEEGGGG")           # G..
res = lambda ch: 20 if ch == "*" else AAS.index(ch)
CODE = np.array([[[res(TABLE[16 * TCAG.index(a) + 4 * TCAG.index(b) + TCAG.index(c)])
                   for c in BASES] for b in BASES] for a in BASES])

# TODO 1: Transcribe. Build the 4x4 that renames T to U, and the 4x4 that
#         complements (A<->T, C<->G). One of them is np.eye(4). Which, and
#         what is the other? Contract each with X over the base axis and
#         check how many of the 42 ones changed column.
# TODO 2: Reshape X into codons: (14, 3, 4). Assert it is a view of X, not a
#         copy. Why is it free?
# TODO 3: One codon is the outer product of its three one-hot rows. Build it
#         with einsum and check it is rank one: 64 entries, exactly one of
#         them 1.
# TODO 4: Translation as a contraction. CODE below is the genetic code as a
#         (4, 4, 4) array of residue indices. Contract each codon's rank-one
#         tensor against it and read off the protein. It should start "MSIY".
# TODO 5: Search. Take the 20-base window at position 10 as a guide and score
#         it against every window with einsum('wlb,lb->w'). How many windows
#         score 20? What does the runner-up score, and why is the gap the
#         whole point?
Trabaja con la secuencia real de 180 bases de interactive/genome-core.js si quieres los números del propio escenario; su procedencia está en interactive/genome-scenes/README.md. La comprobación que importa es la que hace la propia prueba del repositorio: traduce la secuencia con tu tabla del código y compárala con la proteína depositada, residuo a residuo. Si no coincide, el error es tuyo, no del registro.
Apéndice H — Notas para quien imparte
(El alumnado puede saltarse esta sección.)
Estructura. Cuatro partes que se construyen una sobre otra: entender qué es un tensor → razonar por qué existen los ejes → manipular ejes → calcular con tensores y factorizarlos. Las secciones 07, 09 y 10 comparten un tema: no existe una inversa exacta, así que busca la mejor aproximación estable. Decir esa conexión en voz alta en el cierre es lo que hace que la segunda mitad se sienta como una sola lección en vez de como cuatro.
No corras en la Parte I. Es el primer contacto del alumnado con la teoría de tensores y todos los bloques posteriores usan su vocabulario. Si vas con retraso, sigue el orden de Recortes por tiempo indicado más abajo.
Idioma. El alumnado tiene el inglés como segunda lengua (Colombia). Habla despacio, evita los modismos y define los términos la primera vez que los uses. Nombra en voz alta los cognados en español desde el principio —eje, descomposición, contracción, convolución—: quita fricción de inmediato. Invita a preguntar en cualquiera de los dos idiomas. Avisa de los dos sentidos de «rank» al comienzo de la Parte I.
Números verificados. Toda salida citada en este documento se ejecutó y se comprobó: radio medio maligno frente a benigno 17,5/12,1; 3 píxeles de varianza cero en los dígitos; 207 valores faltantes en los datos de vivienda; RMSE de vivienda ≈ 75 980; error de deconvolución 0,1157 → 0,0815 (excluyendo un borde de 25 píxeles); Tucker sobre taxis con compresión 4,71× al 6,7 % de error y el factor de hora con su pico en las 18; para el apéndice E, una grabación de 4,949 s que da una STFT de (513, 465) cuyo mejor rango probado es 40 a 9,08 dB frente a los 5,00 dB de la entrada ruidosa; y, para la sección 09, la Vandermonde de grado 10 de la serie aérea con κ(X) = 2,16e7 y κ(XᵀX) = 4,65e14, con errores de coeficiente de 1,95e-03 por ecuaciones normales frente a 2,04e-14 por QR, y el rango 16 de la imagen astronaut a 21,1 dB. Si alguien obtiene algo distinto, merece investigarse en lugar de descartarse. La única excepción son los tiempos de la sección 09. Son propiedades de la máquina, no de los datos. Una CPU de Colab no los reproducirá, y por eso el apéndice cita razones y no milisegundos.
Las descargas. Tres CSV desde URL raw de GitHub, y el clip de la tormenta desde Wikimedia para las secciones 02 y 05. Cada cuaderno reintenta la descarga y después recurre a la copia propia del taller en este sitio (data/), así que un servidor caído cuesta unos segundos, no una sección. Aun así, confirma en los primeros 5 minutos que la preparación del cuaderno 00 imprimió sus formas: quien reciba el mensaje bilingüe «no se pudo descargar» no tiene red, y debería trabajar en pareja.
Asigna los grupos de antemano para el bloque del pipeline de vídeo; asignarlos en directo cuesta de 3 a 5 minutos.
El bloque de grupo necesita más mano firme que los bloques de ejercicios. Si un grupo sigue en la primera pregunta de diseño a falta de 5 minutos, entra en su canal y diles que dibujen una forma, aunque sea la equivocada. La puesta en común importa más que un boceto correcto.
Los tres cuestionarios de Kahoot. Cada uno son 6 preguntas en kahoot_quiz_1_vocabulary_shapes.xlsx, kahoot_quiz_2_distance_pseudoinverse.xlsx y kahoot_quiz_3_convolution_decompositions.xlsx, situados después de las secciones 04, 07 y 10 respectivamente. Importa cada uno a un kahoot con antelación (Create → Add question → Import → Import spreadsheet); no lo hagas en directo. Presupuesta 5 minutos por cuestionario con el podio incluido; a los grupos les suele apetecer ver la clasificación, y está bien, es la recompensa. Estos suman 15 minutos en total, y llevan el taller de 195 a 210 minutos.
Recortes por tiempo. En este orden: quita el Kahoot 2 (el menos novedoso de los tres: la pseudoinversa vuelve en la diapositiva de la idea única del cierre) y luego el Kahoot 1. Todo lo que queda después del Fin de la ruta esencial de un cuaderno, y todos los apéndices, ya está fuera de los 210 minutos, así que quitarlo no ahorra nada. No quites nunca la §1.3 de la Parte I, la sección 10 ni el Kahoot 3: el último comprueba si Tucker ha calado mientras el resultado de los taxis sigue en pantalla. El apartado Si vas con retraso del guion de facilitación convierte esto en puntos de control por hora, con un recorte para cada uno.
Asperezas conocidas. El TODO 4 del apéndice F es lo más difícil del taller. Quien se salte el recorte del borde concluirá que la deconvolución falló, así que señala el recorte de 25 píxeles con claridad antes de que empiece el ejercicio, no después. El TODO 3 de la sección 07 pide provocar un error a propósito. Habrá quien piense que ha hecho algo mal, así que di de antemano que el error es el resultado esperado.